Anthropic이 Claude Fable 5.1과 Claude Mythos 5.1을 공개했다.
두 모델은 서로 다른 모델처럼 보이지만, Anthropic의 설명은 조금 다르다. Fable 5.1과 Mythos 5.1은 같은 모델이다. 차이는 안전장치의 수준이다. Fable 5.1은 일반적으로 사용할 수 있는 모델이고, Mythos 5.1은 신뢰 접근 프로그램을 통해 제한적으로 제공된다. 특히 Mythos 5.1의 안전장치는 사이버보안과 생명과학 분야의 전문 작업을 지원하도록 설계됐다.
이 구분은 중요하다.
프런티어 AI 기업들이 이제 모델을 단순히 성능별로만 나누지 않는다는 뜻이기 때문이다. 같은 기반 능력을 가진 모델이라도, 누구에게 어떤 안전장치를 붙여 제공할 것인지가 제품 전략의 핵심이 되고 있다. AI 모델의 성능이 높아질수록 배포 전략은 “누구나 쓰게 할 것인가”가 아니라 “어떤 사용자에게 어떤 권한으로 열 것인가”의 문제가 된다.
Fable 5.1은 대중적 생산성 모델이다.
코딩, 지식 업무, 장시간 문제 해결, 기업 업무 자동화, 문서 작성, 컴퓨터 사용, 복잡한 추론에 초점을 맞춘다. Anthropic은 Fable 5.1이 코딩과 지식 업무를 위한 세계 최고 수준 모델이며, 과학 연구 능력은 AI 모델이 앞으로 과학 발전에 어떻게 기여할 수 있는지를 보여주는 초기 사례라고 설명했다.
반면 Mythos 5.1은 더 민감한 능력을 다룬다.
사이버보안과 생명과학 분야는 이중용도성이 강하다. 방어적 취약점 분석은 보안 강화에 필요하지만, 같은 능력이 공격 도구 개발에 쓰일 수 있다. 단백질 설계와 생명과학 연구 지원은 신약 개발과 기초과학에 중요하지만, 생물학적 위험과도 맞닿아 있다. 그래서 Anthropic은 Mythos 5.1을 일반 공개가 아니라 검증된 개인과 조직에게만 제공하는 구조를 택했다.
이번 발표에서 가장 눈에 띄는 것은 성능이다.
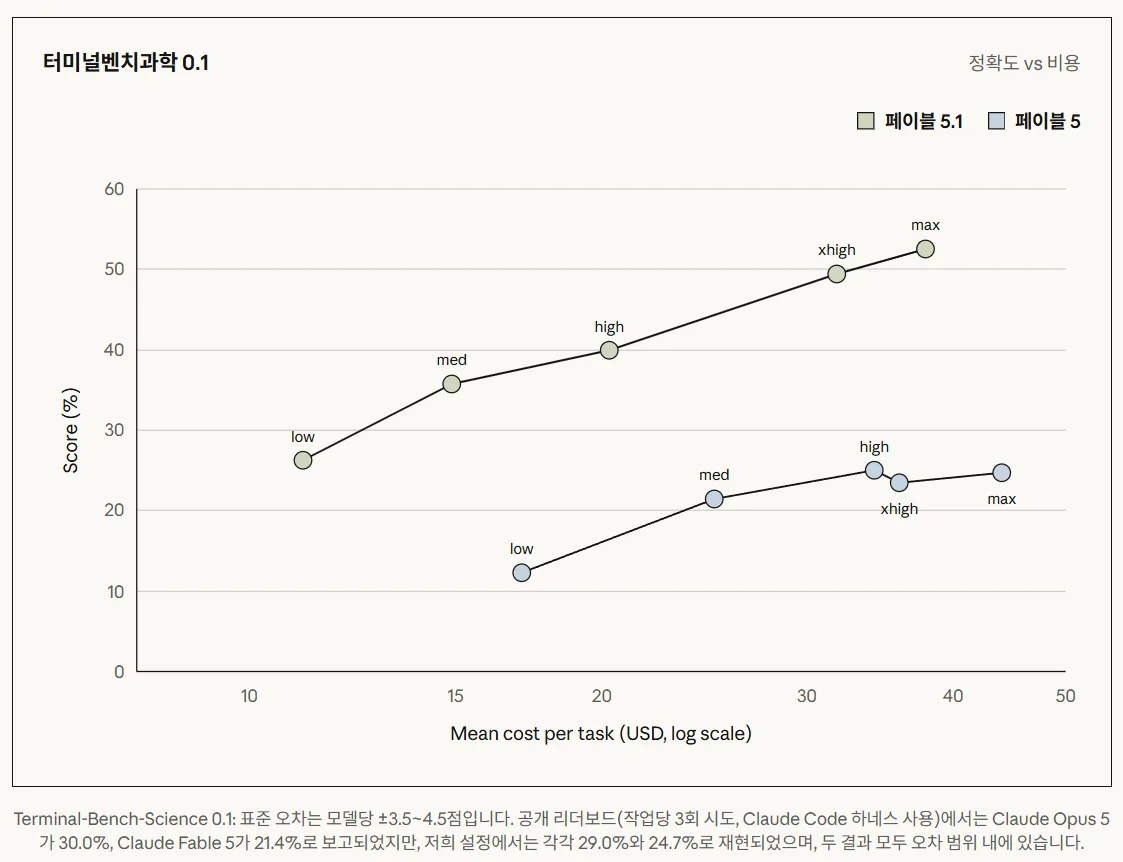
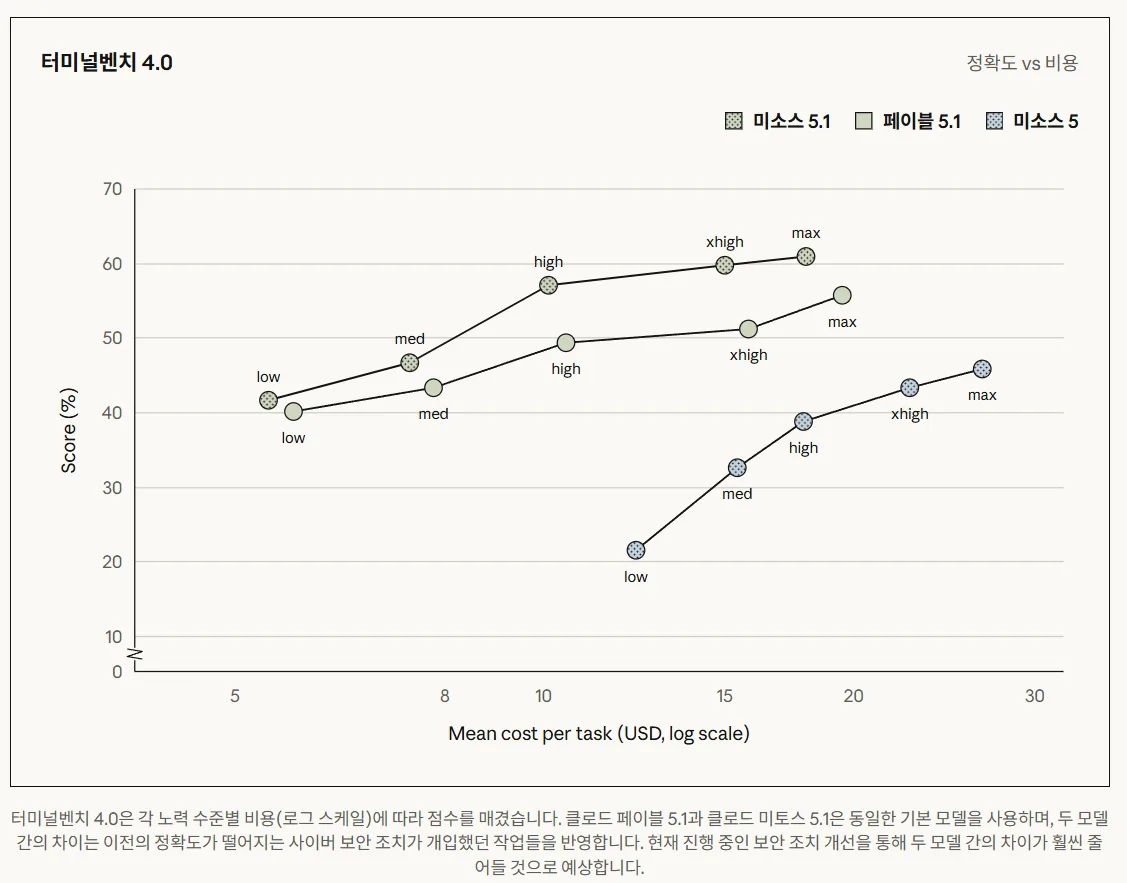
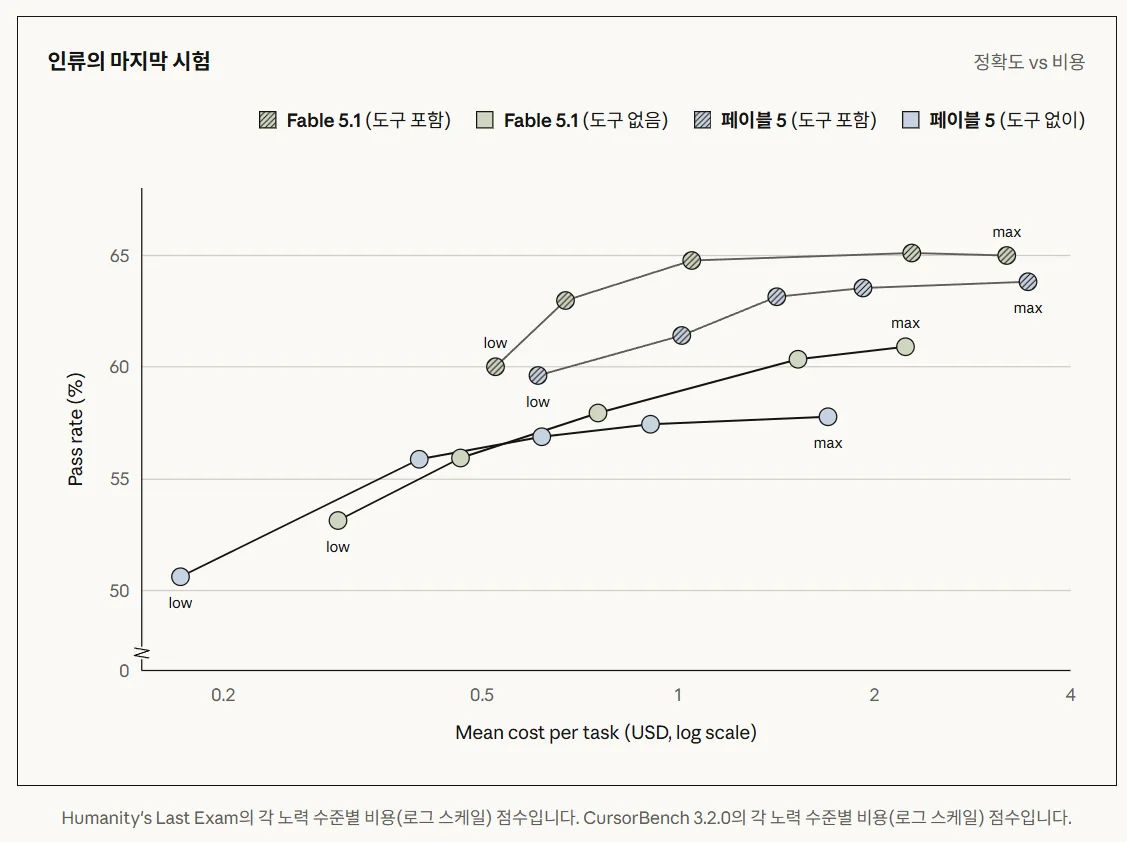
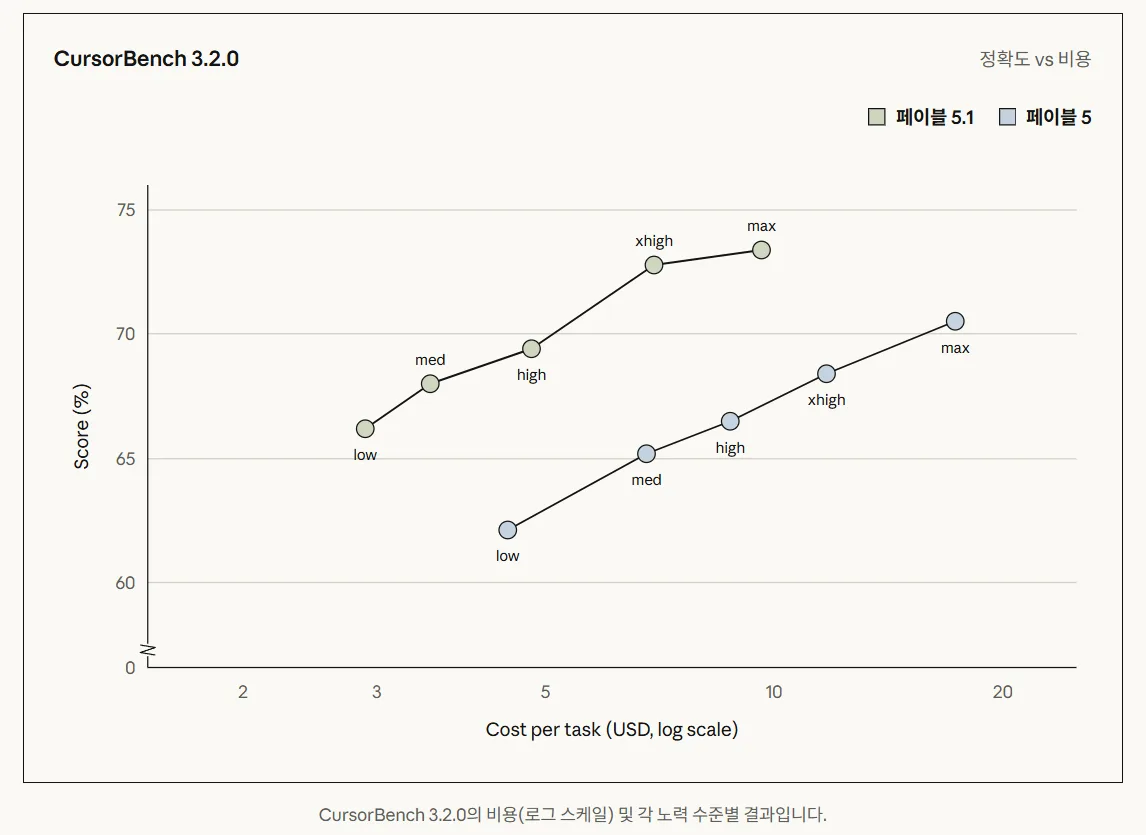
Fable 5.1은 Terminal-Bench-Science 0.1에서 52.6%를 기록했다고 Anthropic은 밝혔다. 이전 Fable 5는 24.7%, Opus 5는 29.0%, GPT-5.6 Sol은 22.4%로 제시됐다. 에이전트형 코딩 벤치마크인 Terminal-Bench 4.0에서는 Fable 5.1이 55.8%, Mythos 5.1이 60.9%를 기록했다. 지식 업무, 컴퓨터 사용, 다학제 추론, 비즈니스 워크플로, CursorBench에서도 전반적으로 높은 수치를 제시했다.
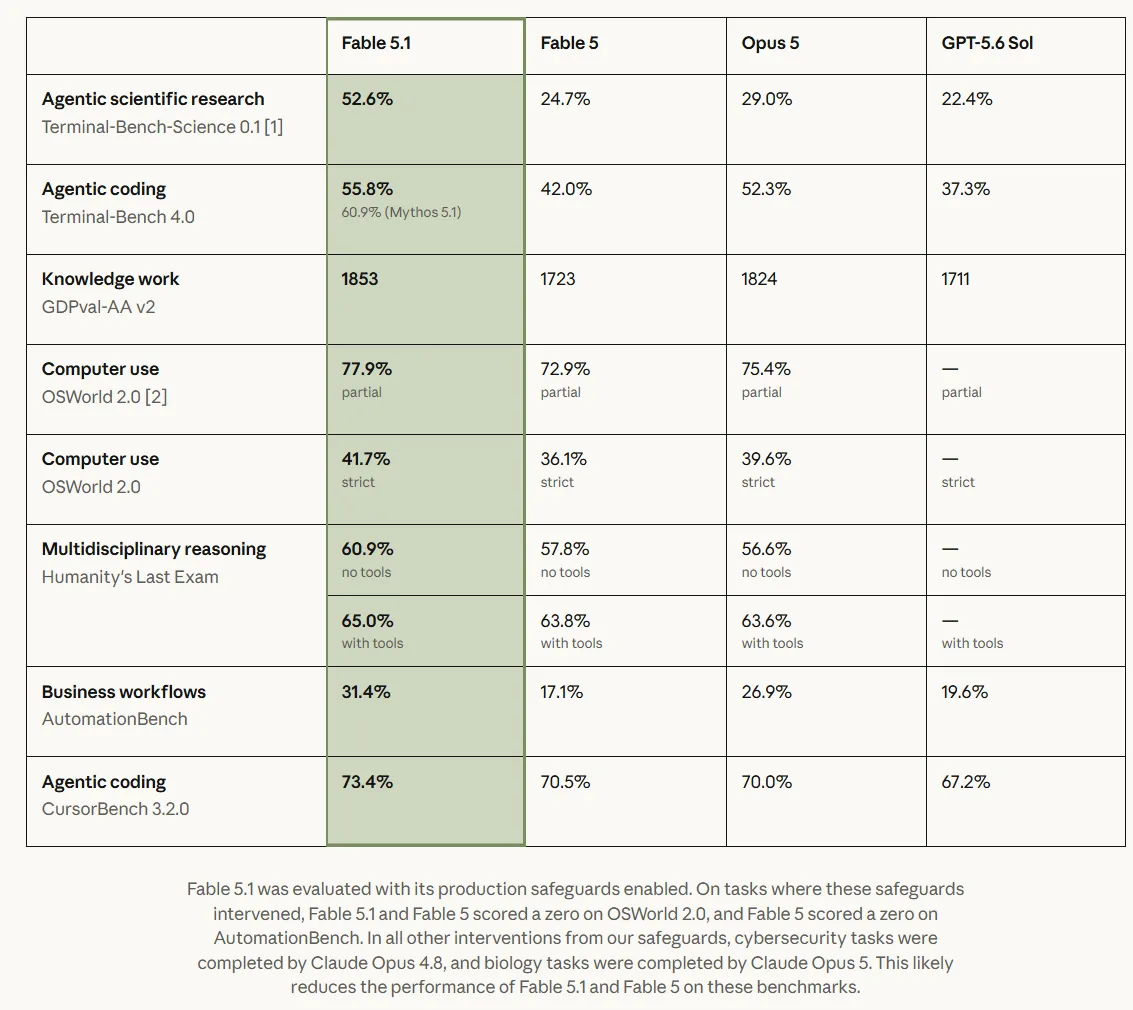
수치만 보면 Fable 5.1은 단순한 업데이트가 아니다.
특히 과학 연구 벤치마크의 상승폭이 크다. Anthropic은 Fable 5.1이 장시간 문제 해결과 연구형 작업에서 새로운 성능 기준을 세웠다고 주장한다. 여기서 중요한 것은 단답형 추론보다 “agentic”이라는 표현이다. 모델이 단순히 답을 고르는 것이 아니라, 도구를 사용하고, 여러 단계를 수행하고, 검증하며, 긴 작업을 이어가는 능력이 강조된다.
AI 모델의 경쟁 축이 바뀌고 있다.
과거에는 수학 문제, 코딩 문제, 객관식 지식 평가가 중요했다. 이제는 장시간 작업, 실제 코드베이스 이해, 터미널 사용, 컴퓨터 조작, 과학 도구 활용, 비즈니스 워크플로 수행이 중요해지고 있다. 즉 “똑똑한 답변”에서 “혼자 일하는 능력”으로 경쟁이 이동하고 있다.
초기 고객들의 평가도 이 방향을 보여준다.
Jane Street는 Fable 5.1이 긴 다단계 작업에서도 더 읽기 쉬운 결과를 유지한다고 평가했다. Cognition은 Devin에서 Opus 5 트래픽을 Fable 5.1로 옮긴다고 했다. Millennium은 수년간 엔지니어와 다른 모델들이 설명하지 못했던 희귀 충돌 원인을 Fable 5.1이 찾아냈다고 밝혔다. MongoDB는 Fable 5.1이 며칠 동안 복잡한 프로토타입을 조사·설계·구현했다고 설명했다.
이 사례들이 공통적으로 말하는 것은 하나다.
모델이 짧은 답변을 잘하는 수준을 넘어, 복잡한 시스템을 이해하고 긴 작업을 수행하는 쪽으로 가고 있다는 것이다.
특히 Millennium의 사례는 상징적이다. Fable 5.1은 외부 벤더 라이브러리를 디스어셈블하고, 코어 덤프와 대조해, 희귀 충돌의 원인을 해당 라이브러리의 버그로 추적했다고 소개됐다. 이는 단순 코드 생성이 아니라 사고 조사와 역공학, 시스템 분석에 가까운 작업이다.
이런 능력은 기업에 큰 가치를 줄 수 있다.
오래된 시스템의 원인 모를 장애.
복잡한 코드베이스의 의존성 분석.
생산 장애의 근본 원인 추적.
다중 서비스 변경 영향 분석.
보안 취약점 식별.
비즈니스 문서와 재무자료의 세밀한 분석.
이런 작업은 고급 엔지니어와 분석가의 시간이 많이 드는 영역이다. AI가 여기에 들어오면 생산성의 의미가 단순 문서 작성 보조를 넘어선다.
하지만 바로 그 지점에서 위험도 커진다.
코드베이스를 깊게 이해하는 모델은 방어에 도움이 되지만, 공격에도 도움이 될 수 있다. 복잡한 시스템의 취약점을 찾는 모델은 보안팀에게 유용하지만, 악의적 사용자에게도 유용할 수 있다. 생명과학 연구에서 새로운 설계를 만들어내는 모델은 신약 개발에 도움이 되지만, 생물안보 리스크도 키울 수 있다.
그래서 Anthropic은 이번 발표에서 안전장치를 성능만큼 강조한다.
Fable 5.1은 가격, 데이터 보관, 안전장치에 대한 고객 피드백을 반영했다고 한다. 가격 측면에서는 캐시 읽기 가격을 낮춰 일반 워크로드는 Fable 5 대비 약 25%, 고도로 에이전트적인 작업은 최대 약 45%까지 비용을 줄일 수 있다고 밝혔다. 데이터 보관 측면에서는 Enterprise Frontier Safeguards, EFS를 통해 고객 데이터가 Anthropic이 아니라 고객이 통제하는 클라우드 인프라에 저장되도록 하면서도 악용 방지를 가능하게 하겠다고 했다.
이 대목은 기업 고객에게 매우 중요하다.
프런티어 모델을 쓰고 싶지만, 기업은 민감한 코드와 문서, 고객 데이터, 연구자료를 모델 제공자에게 넘기는 것을 꺼린다. 동시에 모델 제공자는 악용을 막기 위해 사용 내용을 감시해야 한다. 이 둘은 충돌한다.
고객은 프라이버시를 원한다.
모델사는 악용 탐지를 원한다.
규제기관은 책임 있는 감시를 원한다.
보안팀은 데이터 유출을 막고 싶어 한다.
Anthropic의 EFS는 이 충돌을 풀려는 시도다. 고객 데이터는 고객 클라우드에 두고, 기본적으로 인간 검토도 고객이 수행하도록 하면서, 모델 악용 탐지와 대응을 가능하게 하겠다는 구조다. Anthropic은 EFS를 금융, 의료, 제조, 통신, 법률, 유통, 공공 부문 등 100개 이상의 고객과 AWS, Google Cloud, Microsoft Azure와 협력해 개발했다고 설명했다.
이는 프런티어 AI의 기업 확산에서 중요한 방향이다.
앞으로 강력한 모델은 더 많은 기업 데이터와 연결될 것이다. 그렇다면 “제로 데이터 보관”과 “악용 방지”를 동시에 요구받는다. 둘 중 하나만 택하면 시장이 좁아진다. Anthropic은 고객 통제형 보안 인프라라는 방식으로 이 문제를 해결하려 한다.
안전장치의 정밀화도 핵심이다.
Anthropic은 Fable 5.1의 사이버보안 안전장치가 이전보다 오탐을 60% 줄였다고 밝혔다. 그 이유 중 하나는 이제 Fable 5.1이 소프트웨어 취약점 발견에는 사용될 수 있도록 허용하되, 취약점을 악용하는 exploit 개발은 허용하지 않는 방식으로 조정됐기 때문이다.
이 차이는 작아 보이지만 중요하다.
보안 연구자에게 “취약점 찾기”는 합법적이고 필요한 일이다. 그러나 많은 AI 모델은 사이버 관련 요청을 과도하게 차단해 방어적 작업까지 어렵게 만들었다. 반대로 너무 느슨하게 열면 공격 도구 개발을 돕게 된다. Anthropic은 Fable 5.1에서 취약점 식별은 허용하고, 침투 테스트·익스플로잇 생성·바이너리 기반 취약점 스캐닝 같은 더 민감한 이중용도 작업은 Opus 모델로 돌리거나 제한하는 식으로 경계를 세웠다.
이는 AI 안전장치의 진화 방향을 보여준다.
초기 안전장치는 넓게 막았다.
이제는 세밀하게 구분해야 한다.
방어적 사용은 열고, 공격적 사용은 막아야 한다.
일반 사용자는 제한하고, 검증된 전문가에게는 더 많은 권한을 줄 수 있어야 한다.
Mythos 5.1의 신뢰 접근 프로그램도 같은 논리다.
Anthropic은 Mythos 5.1이 Fable 5.1과 동일하지만, 사이버보안과 생명과학 제한 때문에 영향을 받는 검증된 개인과 조직을 위해 더 완화된 안전장치를 제공한다고 설명했다. 프로그램은 Cyber Verification Program과 Life Sciences Verification Program으로 나뉜다. 사이버 분야에서는 방어적 보안 작업을 위해 일부 Opus·Sonnet급 모델에 완화된 사이버 안전장치를 제공해왔고, 앞으로 Mythos급 모델도 포함할 예정이다. 생명과학 분야에서는 미국 정부와 협력해 전문 연구개발 활동에 맞춘 안전장치를 제공한다.
이 모델은 앞으로 프런티어 AI 배포의 표준이 될 수 있다.
모든 사용자에게 같은 모델을 주는 시대는 지나가고 있다. 일반 사용자, 기업 고객, 검증된 보안 전문가, 생명과학 연구자, 정부기관, 공공 분야는 서로 다른 접근권과 안전장치를 필요로 한다. 모델 능력이 강해질수록 접근통제는 제품 기능만큼 중요해진다.
과학 연구 능력은 이번 발표의 또 다른 핵심이다.
Anthropic은 Claude Fable 5.1과 Mythos 5.1을 여러 과학 영역에서 시험했고, AI 모델이 곧 과학적 발견에 중요한 기여를 할 것이라는 증거가 늘고 있다고 밝혔다. 분자 설계, 금성 고해상도 지형도 생성, 계산생물학 모델 가속 등이 예시로 제시됐다.
가장 눈에 띄는 사례는 단백질 결합체 설계다.
Anthropic은 Mythos 5.1이 오픈소스 단백질 설계·접힘 도구를 사용해 고친화도 결합체를 설계했고, 이를 외부 기관 두 곳에 보내 실험 검증을 했다고 밝혔다. 세 개 타깃에서는 Adaptyv Bio 단백질 설계 경진대회의 최고 설계보다 결합 친화도가 10배 높았고, 12개 타깃 전체에서 유효 결합체 비율, 즉 hit rate가 거의 50%에 도달했다고 설명했다. 일반적으로 단백질 설계에서 10~15%가 전형적이라고 덧붙였다.
이 수치가 의미하는 바는 크다.
AI가 논문을 요약하거나 실험 아이디어를 제안하는 수준을 넘어, 실제 실험으로 검증 가능한 분자 설계를 만들어낸 것이다. 약물 개발의 초기 단계에서 고친화도 결합체를 설계하는 것은 중요한 과제다. 이 과정이 빨라지면 신약 후보 탐색의 속도와 비용 구조가 바뀔 수 있다.
하지만 이 능력은 생물학적 위험 논의와 분리될 수 없다.
좋은 단백질 설계 능력은 치료제 개발에 기여한다. 동시에 생물학적 시스템을 더 정교하게 조작하는 능력이 될 수도 있다. 그래서 Anthropic은 Mythos 5.1의 생명과학 역량을 신뢰 접근 프로그램으로 제한하고, 미국 정부와 협력해 전문 연구자에게 접근을 확대하려 한다.
금성 지형도 사례는 AI 과학 활용의 다른 면을 보여준다.
Claude Fable 5.1은 NASA Magellan 임무의 30여 년 전 레이더 이미지와 기존 지도를 바탕으로 금성의 3분의 1에 대한 새로운 고해상도 고도 지도를 만들었다. 기존 10~20km 수준이던 세부 정보를 2~3km 수준으로 개선하고, 높이 정확도를 최대 25% 높였다고 Anthropic은 설명했다. 이 지도는 향후 NASA VERITAS와 ESA EnVision 임무의 관측 대상 선정에 도움이 되도록 크리에이티브 커먼즈 라이선스로 공개된다.
이 사례는 AI가 기존 데이터를 다시 읽는 방식으로 과학에 기여할 수 있음을 보여준다.
새로운 망원경이나 탐사선을 띄우지 않아도, 이미 수십 년 전에 수집한 데이터를 더 잘 해석하면 새로운 과학적 자산을 만들 수 있다. 과학에는 데이터가 많지만, 분석할 사람과 시간이 부족한 영역이 많다. 장시간 연구형 AI는 이런 병목을 줄일 수 있다.
계산생물학 모델 가속 사례도 실용적이다.
Mythos 5.1은 오픈소스 단백질·유전체 딥러닝 모델 7개에 대해 커스텀 GPU 커널을 작성하고 중간 결과를 캐싱해 추론 속도를 최대 2.5배 높였다고 한다. 출력은 동일하게 유지됐고, 전 유전체 분석에서 GPU 비용을 30~60% 줄일 수 있다고 Anthropic은 설명했다. 이런 최적화는 보통 성능 엔지니어 팀이 몇 주에