Meta가 Muse Code를 공개했다.
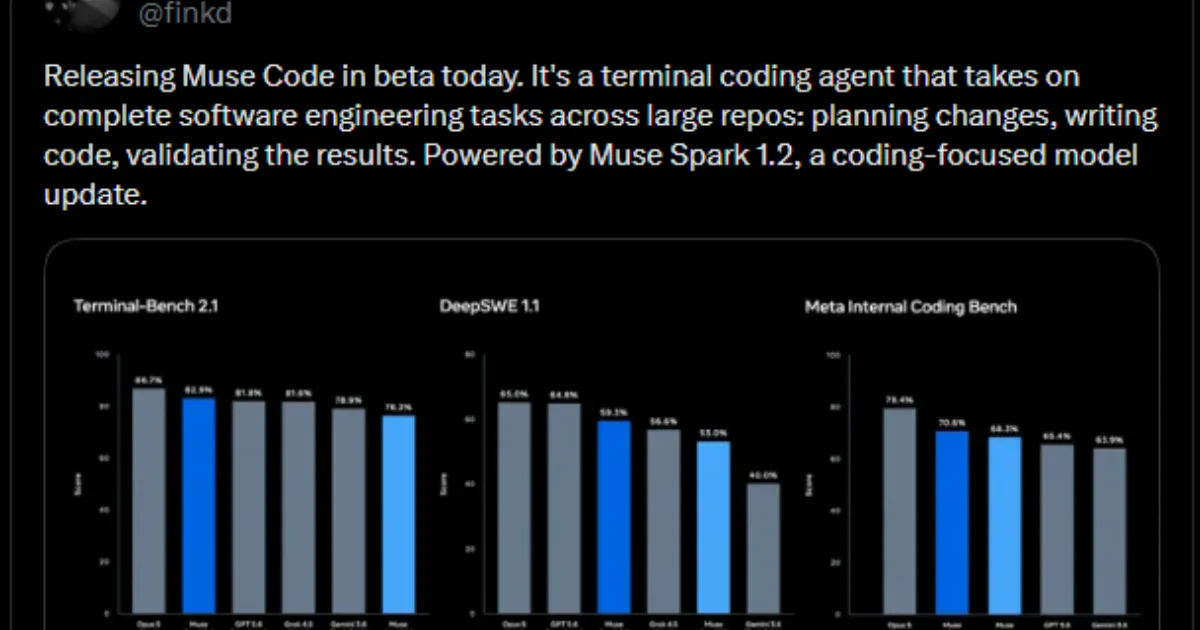
Mark Zuckerberg는 X를 통해 Muse Code 베타 출시를 알렸다. 그는 Muse Code를 terminal coding agent라고 설명했다. 대형 저장소에서 완전한 소프트웨어 엔지니어링 작업을 맡아 변경 계획을 세우고, 코드를 작성하고, 결과를 검증하는 도구라는 것이다. 이 도구는 코딩에 초점을 맞춘 모델 업데이트인 Muse Spark 1.2로 구동된다.
짧은 발표지만 의미는 크다.
Meta가 AI 코딩 도구 경쟁에 본격적으로 들어왔다는 뜻이다. 그리고 그 방향은 단순한 코드 추천이나 자동완성이 아니다. Muse Code는 터미널에서 작동하는 에이전트다. 사용자의 명령을 받아 코드 몇 줄을 제안하는 도구가 아니라, 큰 작업을 계획하고, 여러 도구를 호출하고, 파일을 수정하고, 검증까지 수행하는 장시간 작업형 개발 에이전트를 지향한다.
AI 코딩 도구 시장은 이미 빠르게 바뀌고 있다.
초기 경쟁은 누가 더 좋은 코드를 제안하느냐였다. 이후에는 IDE 안에서 얼마나 자연스럽게 코드 작성과 리팩터링을 도와주느냐가 중요해졌다. 이제 경쟁은 한 단계 더 나아갔다. 개발자가 문제를 설명하면 AI가 저장소 전체를 읽고, 변경 계획을 세우고, 여러 파일을 수정하고, 테스트를 돌리고, 실패하면 다시 고치고, 결과를 PR 형태로 내놓는 방향이다.
Muse Code는 바로 이 흐름 위에 있다.
코딩 AI는 더 이상 옆에서 조언하는 조수가 아니다.
점점 작은 개발자처럼 일하려 한다.
Muse Code가 강조한 세 가지
Zuckerberg의 연속 게시물에서 Muse Code의 핵심 특징은 크게 세 가지로 보인다.
첫째는 장시간 맥락 유지다.
Muse Code는 세션 전체에서 계속 활성화된 specialized background agents를 실행한다고 설명됐다. 이 에이전트들은 매 작업마다 처음부터 다시 시작하지 않고, 시간이 지날수록 맥락을 쌓아간다.
이것은 대형 저장소 작업에서 중요하다.
소프트웨어 개발은 한 번의 질문과 답으로 끝나지 않는다. 저장소 구조를 파악하고, 의존성을 이해하고, 기존 코드 스타일을 읽고, 테스트 방식을 확인하고, 이전 실패를 기억해야 한다. 매번 새로 시작하는 AI는 같은 맥락을 반복해서 설명해야 하고, 긴 작업에서 방향을 잃기 쉽다.
Muse Code는 이 문제를 background agent로 풀려 한다.
둘째는 병렬 sub-agent다.
작업이 충분히 크면 Muse Code는 별도의 sub-agent로 작업을 fan out한다. 이 sub-agent들은 격리된 worktree에서 병렬로 일한다. 이는 한 AI가 순차적으로 모든 파일을 고치는 방식보다 더 확장성 있는 접근이다.
대형 기능 개발이나 최적화 작업은 여러 가설을 동시에 시험해야 할 수 있다. 하나의 접근이 실패하면 다른 접근을 시도해야 하고, 서로 다른 모듈을 병렬로 분석해야 한다. 격리된 worktree는 충돌을 줄이면서 여러 시도를 동시에 가능하게 한다.
셋째는 auditability다.
Zuckerberg는 Muse Code가 auditable by design이라고 설명했다. 모든 model call, tool run, edit가 실행되기 전에 local event log에 기록된다. 중간에 crash가 나도 이 로그를 바탕으로 정확히 중단 지점에서 재개할 수 있다. 작업 손실도 없고, 다시 프롬프트를 입력할 필요도 없다는 설명이다.
이 세 가지는 모두 같은 방향을 가리킨다.
AI 코딩 에이전트가 오래 일하려면 기억해야 한다.
크게 일하려면 병렬화해야 한다.
믿고 맡기려면 감사 가능해야 한다.
코딩 AI의 경쟁축이 바뀌고 있다
Muse Code 발표는 AI 코딩 시장의 경쟁축 변화를 잘 보여준다.
지금까지 많은 코딩 AI는 개발자가 코드를 쓰는 순간을 돕는 데 초점을 맞췄다. 자동완성, 함수 생성, 오류 설명, 간단한 리팩터링, 테스트 코드 작성이 주요 사용 사례였다. 개발자는 여전히 작업 흐름을 직접 통제했고, AI는 중간중간 제안하는 도구였다.
하지만 최근 경쟁은 다르다.
Claude Code, OpenAI Codex 계열 도구, Cursor의 에이전트형 기능, 그리고 Meta의 Muse Code까지 모두 더 긴 작업을 겨냥한다. 목표는 “코드를 제안하는 AI”가 아니라 “작업을 맡아 수행하는 AI”다.
이 차이는 크다.
코드 제안형 AI는 개발자가 모든 맥락과 결정을 쥐고 있다.
작업 수행형 AI는 목표를 받고 스스로 경로를 찾는다.
코드 제안형 AI는 한 파일이나 한 함수에 강하다.
작업 수행형 AI는 저장소 전체와 테스트, 실행 환경까지 봐야 한다.
따라서 필요한 기술도 달라진다.
긴 맥락 이해.
도구 호출 능력.
터미널 작업.
파일 수정과 검증.
테스트 실행.
실패 후 재시도.
작업 로그.
권한 통제.
병렬 에이전트 조율.
Muse Code가 background agent, isolated worktree, local event log를 강조한 것은 이 때문이다.
앞으로 코딩 AI의 성능은 단순 benchmark 점수보다 실제 개발 작업을 얼마나 끝까지 가져가느냐로 평가될 가능성이 크다.
24시간, 1,000회 이상 tool call의 의미
Zuckerberg는 Muse Spark 1.2를 NVIDIA Hopper의 kernel optimization task에 투입했고, 24시간 동안 1,000회 이상의 tool call을 수행했다고 밝혔다. 초기 탐색 단계를 넘어 계속 실질적인 개선을 찾아냈다는 설명도 덧붙였다.
이 대목은 상징적이다.
AI 에이전트가 몇 분 동안 코드를 고치는 수준을 넘어, 하루 동안 계속 실험하고 최적화하는 방향으로 가고 있다는 뜻이다. 특히 kernel optimization은 단순 CRUD 기능 개발과 다르다. 성능 측정, 가설 설정, 코드 수정, 벤치마크 반복, 하드웨어 특성 이해가 필요하다.
물론 X 게시물만으로 구체적 성과나 비교 수치를 검증할 수는 없다. 어떤 kernel task였는지, baseline은 무엇이었는지, 개선 폭이 어느 정도였는지, 사람이 얼마나 개입했는지는 공개된 정보만으로 알 수 없다.
그럼에도 24시간·1,000회 tool call이라는 표현이 보여주는 방향은 분명하다.
Meta는 Muse Code를 짧은 코딩 보조가 아니라 long-running autonomous engineering agent로 포지셔닝하고 있다.
이런 도구가 실제로 작동한다면 개발 방식은 바뀐다.
사람은 퇴근 전 큰 작업을 맡긴다.
AI는 밤새 여러 가설을 시험한다.
아침에 결과와 로그, 수정안, 검증 결과를 확인한다.
개발자는 최종 판단과 리뷰를 맡는다.
Nuro가 overnight research agent를 쓰는 방식이나, Anthropic이 Claude Code auto mode에서 장시간 자율 작업을 강조하는 흐름과도 연결된다.
AI 개발의 다음 생산성은 “초안 속도”가 아니라 “비동기 장시간 작업”에서 나올 수 있다.
감사 가능한 에이전트가 중요한 이유
Muse Code의 local event log는 단순 장애 복구 기능이 아니다.
AI 에이전트 시대의 신뢰 장치다.
개발 작업에서 AI가 무엇을 했는지 알 수 있어야 한다. 어떤 모델 호출이 있었는지, 어떤 도구를 실행했는지, 어떤 파일을 수정했는지, 어떤 명령이 실행됐는지, 어떤 시점에 실패했는지 추적할 수 있어야 한다.
특히 장시간 자율 작업에서는 감사 가능성이 필수다.
AI가 코드를 바꿨는데 이유를 알 수 없다면 위험하다.
테스트를 돌렸다고 했는데 실제로 무엇을 실행했는지 모르면 신뢰하기 어렵다.
중간에 crash가 발생했을 때 작업 맥락이 사라지면 다시 시작해야 한다.
여러 sub-agent가 병렬 작업했다면 어떤 agent가 무엇을 바꿨는지 알아야 한다.
local event log는 이런 문제를 해결하려는 장치로 보인다.
또한 보안 관점에서도 중요하다. 최근 AI 코딩 에이전트의 위험은 단순 코드 오류가 아니다. 파일 삭제, 비밀정보 외부 전송, 잘못된 권한 변경, 과도한 shell command, prompt injection으로 인한 의도치 않은 행동이 문제가 된다.
모든 실행 기록이 남아야 사후 감사와 복구가 가능하다.
AI 에이전트가 더 자율적으로 일할수록, 더 많은 로그가 필요하다.
Meta가 노리는 것은 개발자 생태계다
Meta는 AI 인프라와 모델, 오픈소스 생태계에서 강한 존재감을 만들어왔다.
Muse Code는 그 흐름을 개발자 도구 영역으로 확장하는 시도다. 특히 terminal coding agent라는 포지션은 개발자의 실제 작업 환경에 가까이 들어가겠다는 뜻이다. IDE 플러그인보다 더 낮은 층에서, 저장소와 shell, toolchain을 직접 다루는 방식이다.
개발자 도구 시장은 전략적으로 중요하다.
AI 모델이 아무리 강해도 개발자가 매일 쓰는 워크플로에 들어가지 못하면 영향력이 제한된다. 반대로 코딩 도구로 자리 잡으면 모델은 매일 수많은 실제 과제를 통해 사용된다. 저장소 이해, 테스트, 배포, 리팩터링, 최적화 같은 고가치 업무에 깊게 연결된다.
OpenAI, Anthropic, Google, Microsoft, Meta가 코딩 에이전트에 집중하는 이유도 여기에 있다.
개발자는 AI의 가장 적극적인 사용자다.
코딩은 에이전트 능력을 검증하기 좋은 영역이다.
소프트웨어 개발은 경제적 가치가 크다.
도구 사용과 장시간 작업이 자연스럽다.
기업 도입 가능성도 높다.
Muse Code는 Meta가 이 시장에서 뒤처지지 않겠다는 신호다.
Muse Spark 1.2의 포지션
Muse Code는 Muse Spark 1.2로 구동된다.
Zuckerberg는 Muse Spark 1.2를 frontier로 가기 위한 다음 단계라고 표현했다. 더 크고 더 강력한 모델들이 앞으로 올 것이라고도 밝혔다.
이 문장은 Meta의 전략적 위치를 보여준다.
Muse Spark 1.2가 현재 최종 목표가 아니라는 뜻이다. Meta는 코딩 중심 모델 업데이트를 통해 개발자 도구를 먼저 내놓고, 향후 더 큰 모델로 성능을 끌어올리려는 것으로 보인다.
AI 코딩 에이전트에서 모델 성능은 중요하다.
하지만 모델만으로 충분하지 않다. Claude Code auto mode가 보여준 것처럼 권한 통제와 위험 명령 차단이 필요하다. Muse Code가 강조한 것처럼 background agent, worktree 병렬화, event log도 필요하다. 즉 제품 아키텍처와 모델이 함께 가야 한다.
Muse Spark 1.2는 그 제품 아키텍처 안에 들어가는 엔진이다.
앞으로 더 강한 모델이 붙으면 Muse Code의 장시간 작업 능력은 더 커질 수 있다. 반대로 강한 모델일수록 잘못된 명령과 의도치 않은 행동 위험도 커진다. 따라서 감사 로그와 격리된 worktree 같은 구조는 더 중요해진다.
Meta가 frontier 모델을 향해 간다면, Muse Code는 그 모델을 실제 개발 작업에 연결하는 실험장이 될 수 있다.
Claude Code·Codex와의 경쟁
Muse Code는 자연스럽게 Claude Code와 OpenAI Codex 계열 도구와 비교될 수밖에 없다.
Claude Code는 터미널 기반 개발 에이전트로 장시간 작업, 도구 호출, 권한 관리, auto mode를 강조한다. OpenAI도 Codex와 ChatGPT Work 흐름을 통해 개발 작업과 업무 자동화 에이전트를 밀고 있다. Cursor는 IDE 중심에서 에이전트형 코딩 경험을 강화해왔다.
Muse Code는 이 경쟁에 Meta식 답을 내놓은 것으로 볼 수 있다.
세션 전체에서 살아 있는 background agent.
작업이 크면 sub-agent로 fan out.
격리된 worktree 병렬 작업.
local event log 기반 감사와 재개.
Muse Spark 1.2 기반 코딩 특화 모델.
경쟁 포인트는 명확하다.
첫째, 누가 더 큰 저장소를 잘 이해하는가.
둘째, 누가 더 오래 안정적으로 작업하는가.
셋째, 누가 더 적은 인간 개입으로 검증까지 마치는가.
넷째, 누가 더 안전하게 명령을 실행하는가.
다섯째, 누가 더 좋은 개발자 경험과 가격을 제공하는가.
Zuckerberg가 설치가 쉽고 contributor tier로 낮은 비용으로 시작할 수 있다고 강조한 것도 시장 진입 전략이다. 개발자 도구는 처음 써보는 장벽이 낮아야 한다. 설치와 가격이 간단해야 사용자가 빠르게 실험한다.
코딩 에이전트 시장은 아직 초기다.
하지만 경쟁은 이미 격해지고 있다.
병렬 에이전트는 개발 조직의 축소판이다
Muse Code의 sub-agent 병렬 작업 구조는 흥미롭다.
큰 작업이 생기면 별도 sub-agent들이 격리된 worktree에서 동시에 일한다. 이는 실제 개발 조직의 축소판처럼 보인다. 여러 개발자가 같은 목표를 두고 서로 다른 브랜치에서 작업하고, 결과를 비교하고, 좋은 접근을 선택하는 방식과 닮았다.
AI 에이전트가 발전하면 소프트웨어 개발은 “한 명의 AI가 모든 것을 하는 구조”보다 “여러 AI가 역할을 나눠 작업하는 구조”로 갈 가능성이 크다.
한 agent는 코드베이스를 분석한다.
다른 agent는 테스트를 작성한다.
다른 agent는 성능 최적화를 시도한다.
다른 agent는 보안 리스크를 검토한다.
critic agent는 결과를 비교한다.
main agent는 최종 변경안을 통합한다.
Muse Code의 fan out 구조는 이런 방향을 암시한다.
다만 병렬화에는 위험도 있다. 여러 에이전트가 동시에 수정하면 충돌이 생길 수 있다. 서로 다른 가정으로 작업할 수 있다. 검증 비용이 늘어날 수 있다. 어떤 결과가 최선인지 판단하는 orchestration이 중요해진다.
따라서 코딩 에이전트의 다음 기술 과제는 개별 모델 지능만이 아니다.
여러 에이전트를 어떻게 조율할 것인가다.
AI 코딩 에이전트의 보안 문제
Muse Code 발표에서 감사 로그와 격리 worktree가 강조된 것은 긍정적이다.
하지만 AI 코딩 에이전트는 본질적으로 보안 리스크를 동반한다. 터미널 접근권을 갖고, 파일을 수정하고, 도구를 실행하고, 네트워크를 사용할 수 있기 때문이다. 특히 장시간 자율 작업은 위험을 키울 수 있다.
위험은 여러 형태로 나타난다.
의도치 않은 파일 삭제.
비밀정보가 포함된 파일 외부 전송.
잘못된 git push.
production credential 사용.
테스트 환경과 운영 환경 혼동.
prompt injection을 통한 행동 탈취.
패키지 설치 과정의 공급망 공격.
과도한 권한 요청.
보안 취약 코드 생성.
최근 AI 사이버 평가 사고와 Claude Code auto mode 논의는 모두 같은 방향을 가리킨다. 에이전트는 강력해질수록 행동 통제가 필요하다. 사람이 모든 명령을 승인하는 방식은 피로를 만들고, 완전 자동 실행은 위험하다. 따라서 모델 호출과 도구 실행, 편집 기록을 남기고, 위험 명령을 차단하고, 작업 범위를 격리해야 한다.
Muse Code가 event log를 강조한 것은 시작일 뿐이다.
앞으로 사용자는 다음을 요구할 것이다.
어떤 명령이 실행됐는가.
어떤 파일이 바뀌었는가.
어떤 외부 네트워크 접근이 있었는가.
비밀정보가 노출되지 않았는가.
작업이 격리된 환경에서 이뤄졌는가.
실패 시 되돌릴 수 있는가.
PR 리뷰 전에 어떤 검증이 완료됐는가.
AI 코딩 에이전트의 신뢰는 코드 품질만이 아니라 통제 가능성에서 나온다.
한국 개발 조직에 주는 시사점
한국 기업과 개발 조직에도 Muse Code 발표는 의미가 있다.
많은 조직이 AI 코딩 도구를 도입하고 있지만, 아직은 개인 생산성 도구로 보는 경우가 많다. 개발자가 알아서 Copilot이나 ChatGPT, Claude Code를 쓰고, 코드 일부를 생성하거나 디버깅에 활용하는 식이다.
그러나 Muse Code 같은 도구가 확산되면 양상이 달라진다.
AI가 저장소 전체를 분석한다.
장시간 작업을 수행한다.
여러 파일을 수정한다.
테스트와 검증을 실행한다.
PR 형태로 결과를 가져올 수 있다.
밤새 작업하고 아침에 결과를 확인하는 방식이 가능해진다.
이때 개발 조직은 새로운 운영 원칙을 세워야 한다.
첫째, AI 에이전트가 접근 가능한 저장소와 브랜치를 제한해야 한다.
둘째, 운영 자격 증명과 민감 파일 접근을 막아야 한다.
셋째, AI가 만든 변경은 반드시 코드 리뷰와 테스트를 거쳐야 한다.
넷째, 실행 로그와 변경 기록을 보존해야 한다.
다섯째, 병렬 에이전트 작업 결과를 통합하는 기준이 필요하다.
여섯째, 보안·라이선스·개인정보 이슈를 자동 검사해야 한다.
일곱째, AI가 할 수 있는 작업과 사람이 승인해야 하는 작업을 구분해야 한다.
AI 코딩 에이전트는 개발 생산성을 높일 수 있다.
하지만 조직의 SDLC 안으로 들어오지 않으면 통제되지 않는 자동화가 된다.
개발자의 역할은 사라지지 않는다
Muse Code 같은 도구가 나오면 개발자의 역할이 줄어드는 것처럼 보일 수 있다.
하지만 실제 변화는 역할의 이동에 가깝다.
개발자는 모든 코드를 직접 쓰는 사람에서, 목표를 정의하고, 맥락을 제공하고, AI가 만든 변경을 검토하고, 설계 판단을 내리는 사람으로 이동한다. 특히 대형 저장소에서는 AI가 많은 파일을 수정할 수 있지만, 그 변경이 제품 방향과 아키텍처 원칙, 보안 요구, 운영 현실에 맞는지는 사람이 판단해야 한다.
AI가 코드를 쓸수록 사람의 설계 책임은 더 커진다.
무엇을 만들 것인가.
어떤 제약이 있는가.
어떤 품질 기준을 적용할 것인가.
어떤 변경은 허용하고 어떤 변경은 막을 것인가.
성능 개선이 실제 제품에 의미가 있는가.
테스트가 충분한가.
리스크는 무엇인가.
AI 코딩 에이전트는 개발자의 손을 덜어줄 수 있다.
하지만 판단을 없애지는 못한다.
오히려 판단하지 않는 개발 조직은 AI가 만든 그럴듯한 변경에 더 쉽게 휘둘릴 수 있다.
결론: 코딩 에이전트의 다음 기준은 ‘오래 일하고, 남기고, 검증하는 능력’이다
Meta의 Muse Code 공개는 AI 코딩 도구 시장의 다음 국면을 보여준다.
Muse Code는 터미널 기반 코딩 에이전트다. 대형 저장소에서 완전한 소프트웨어 엔지니어링 작업을 맡아 계획하고, 코드를 작성하고, 결과를 검증하는 것을 목표로 한다. Muse Spark 1.2가 이를 구동하며, 세션 전체에서 유지되는 background agent, 큰 작업을 병렬 sub-agent로 나누는 구조, isolated worktree, local event log 기반 감사와 재개 기능을 강조한다.
이 발표의 의미는 단순하다.
AI 코딩 경쟁은 코드 조각 생성에서 장시간 자율 작업으로 이동하고 있다.
앞으로 중요한 것은 모델이 한 번의 프롬프트에 얼마나 좋은 함수를 쓰느냐가 아니다. 대형 저장소를 이해하고, 작업 계획을 세우고, 여러 접근을 병렬로 시험하고, 테스트를 돌리고, 실패를 복구하고, 모든 과정을 로그로 남기며, 사람이 리뷰할 수 있는 결과물을 만드는 능력이다.
Muse Code는 Meta가 이 전쟁에 참여했다는 신호다.
OpenAI, Anthropic, Cursor, Microsoft, Google에 이어 Meta까지 코딩 에이전트 경쟁에 뛰어들면서 개발 도구 시장은 더 빠르게 재편될 가능성이 크다.
그러나 기술의 방향이 분명할수록 질문도 분명해진다.
AI에게 어디까지 맡길 것인가.
AI가 바꾼 코드를 어떻게 검증할 것인가.
AI의 명령 실행을 어떻게 통제할 것인가.
장시간 자율 작업의 로그와 책임은 어떻게 관리할 것인가.
병렬 에이전트가 만든 결과를 누가 최종 판단할 것인가.
AI 코딩 에이전트 시대의 개발자는 코드를 덜 쓰게 될 수 있다.
하지만 더 많이 설계하고, 더 많이 검토하고, 더 많이 통제해야 한다.
Muse Code의 등장은 그래서 단순한 새 도구 출시가 아니다.
소프트웨어 개발이 사람과 AI 에이전트의 협업 구조로 재편되고 있다는 또 하나의 신호다.