알리바바 Qwen-Audio-3.1-TTS-Next 공개…장면 전체의 소리를 대본으로 설계하는 방식 제시
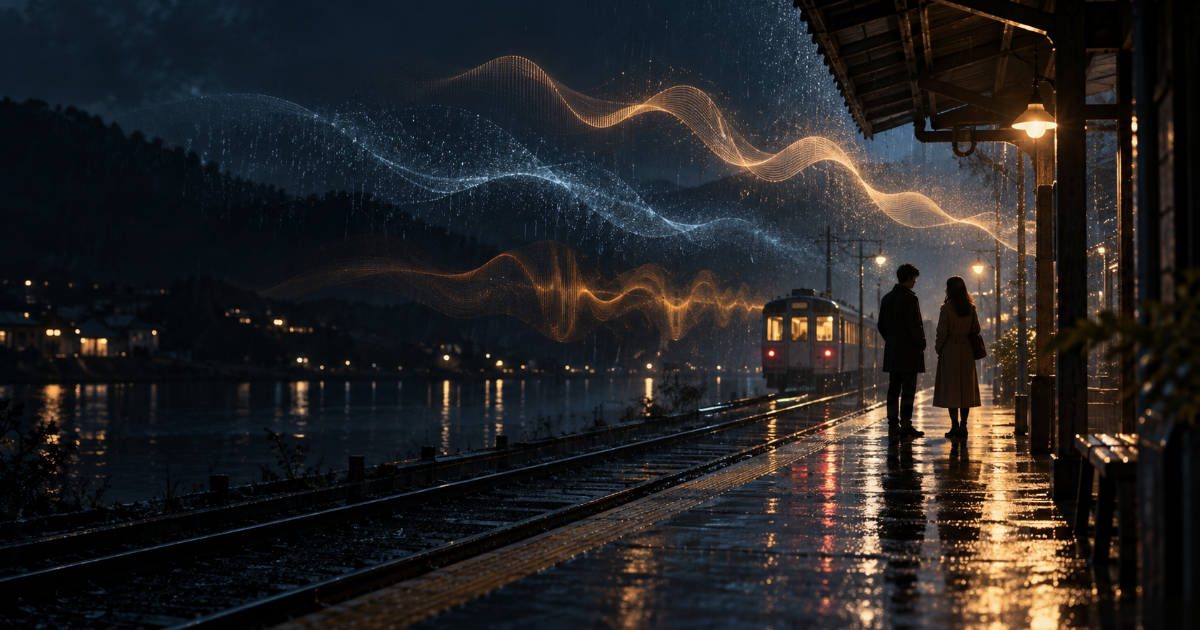
비가 내리는 밤, 기차역 플랫폼에서 두 사람이 짧은 대화를 나눈다. 대사가 멈춘 사이에는 열차가 낮게 움직이는 소리가 들리고, 멀리서 출발 신호가 울린다. 한 사람이 돌아서면 발걸음 소리가 점점 멀어진다.
영상으로 보면 하나의 장면이지만, 소리 작업에서는 여러 요소가 겹쳐 있다. 인물의 목소리를 준비하고, 빗소리와 열차 소리를 구하고, 대사에 방해되지 않도록 각각의 크기와 위치를 조절해야 한다. 분위기를 확인하기 위한 임시 편집본을 만들 때도 이 과정을 어느 정도 거친다.
알리바바가 9월 22일 발표한 Qwen-Audio-3.1-TTS-Next는 이 여러 소리를 하나의 대본에서 함께 생성하도록 설계된 모델이다. 알리바바는 이를 대사와 환경음을 결합해 장면의 오디오를 만드는 기술로 소개했다. 오디오북, 영화·방송, 팟캐스트, 게임이 제시된 활용 분야다.
목소리를 읽어주는 AI에서 소리의 흐름을 만드는 AI로
기존의 텍스트 음성 변환을 떠올리면, 문장을 입력하고 읽어주는 목소리를 얻는 방식이 먼저 생각난다. Qwen-Audio-3.1-TTS-Next가 겨냥하는 작업은 그보다 넓다. 누가 말하는지, 어떤 감정으로 말하는지, 뒤에서 무엇이 들리는지, 소리가 어떤 순서로 나타나는지를 함께 기술해 오디오 장면을 생성한다.
알리바바 클라우드가 공개한 사용 안내에도 기차역을 배경으로 한 영화 장면 예시가 있다. 두 인물의 목소리와 대사뿐 아니라 금속 지붕에 닿는 빗소리, 멀리 있는 열차, 옷감이 스치는 소리, 발걸음의 움직임까지 한 입력에 적는 방식이다. 안내문은 대사와 장면 지시를 구별하고, 소리의 전환 순서를 설명하도록 권한다.
여기서 주목할 부분은 ‘효과음을 많이 넣을 수 있다’는 사실만이 아니다. 제작자가 소리를 요청하는 단위가 한 문장에서 한 장면으로 넓어진다는 점이다. “이 대사를 낮은 목소리로 읽어줘”에서 “인물이 말을 멈춘 뒤에도 빗소리는 남고, 그다음 열차가 출발하도록 해줘”로 입력 방식이 달라지는 셈이다.
이 변화는 영상제작자가 익숙한 콘티 작업과도 닮아 있다. 콘티가 화면에 들어올 인물과 사물, 움직임을 미리 설계한다면, 이 모델에 입력하는 설명은 장면 안에서 들릴 소리의 순서와 관계를 설계한다. 소리를 나중에 덧붙이는 요소로 두지 않고, 장면을 구상할 때부터 함께 생각하게 만든다.
제작 현장에서는 어디에 먼저 쓸 수 있을까
가장 현실적인 활용 가능성은 초벌 사운드 시안이다. 단편영화나 광고 영상을 기획할 때, 감독과 편집자가 머릿속에 떠올리는 장면의 분위기는 같지 않을 수 있다. 한 사람은 비가 거세게 내리는 장면을 상상하고, 다른 사람은 인물 사이의 침묵이 더 크게 들리는 장면을 상상한다.
이때 대사와 환경음이 함께 들어간 짧은 시안을 만들 수 있다면, “어떤 느낌으로 만들자”는 설명을 실제로 들으며 논의할 수 있다. 촬영 전에는 사운드 콘셉트를 검토하고, 편집 초기에는 화면과 소리의 리듬이 맞는지 확인하는 자료로 삼을 수 있다. 게임이나 애니메이션 제작에서도 완성된 녹음 전에 장면의 대화와 공간감을 시험하는 용도를 생각해볼 수 있다.
다만 이는 공개된 기능에서 추론한 활용 방식이다. 여러 효과음을 찾아 임시로 배치하는 작업보다 실제로 빠른지, 수정 요청을 반복할 때도 효율적인지, 결과물이 영상 컷에 얼마나 잘 맞는지는 별도의 제작 테스트가 필요하다. 발표 자료만으로 현장의 작업 시간이나 비용이 줄어든다고 단정할 수는 없다.
‘한 번에 생성’과 ‘자유롭게 편집’은 다른 이야기
영상 사운드는 결과를 만드는 것만큼 수정하는 일이 중요하다. 대사가 배경에 묻히면 빗소리를 낮춰야 하고, 컷이 짧아지면 발소리를 당겨야 한다. 화면 밖 인물의 존재를 늦게 드러내기 위해 특정 소리만 남겨두기도 한다.
Qwen-Audio-3.1-TTS-Next는 음성과 효과음, 환경음을 결합한 오디오를 생성한다고 설명한다. 그러나 현재 확인한 모델 안내만으로는 생성된 대사·효과음·환경음을 각각 독립된 트랙으로 받아 세밀하게 편집할 수 있는지 판단할 수 없다. 완성된 소리가 자연스럽게 들리는 것과 후반 작업에서 원하는 요소만 고칠 수 있는 것은 서로 다른 능력이다.
실제 제작에 적용한다면 이 부분이 중요한 평가 기준이 될 것이다. 마음에 들지 않는 한 단어의 발음만 바꿀 수 있는지, 배경의 열차 소리만 줄일 수 있는지, 같은 인물의 목소리를 여러 컷에 걸쳐 일관되게 유지할 수 있는지에 따라 활용 범위가 달라진다. 현재로서는 이러한 편집 자유도를 확인한 현장 검증 결과로 소개하기 어렵다.
한국어 영상제작자가 확인해야 할 현재의 제한
모델 사양에서 가장 먼저 확인할 부분은 지원 언어가 중국어와 영어로 명시돼 있다는 점이다. 한국어 대사를 중심으로 만드는 국내 영상에 곧바로 적용할 수 있다고 소개해서는 안 된다. 다른 Qwen 계열 모델의 언어 지원 범위를 이 모델에도 그대로 적용하는 것 역시 정확하지 않다.
생성 길이에도 제한이 있다. 공식 문서에 따르면 한 번의 요청에서 팟캐스트는 최대 4분, 그 밖의 장면은 최대 2분의 오디오를 출력한다. 입력 길이는 최대 3,000자이며, 참고 음성은 최대 세 개까지 사용할 수 있다. 따라서 장편 작품의 사운드를 한 번에 완성하는 도구라기보다, 현재 사양으로는 짧은 장면이나 구간을 단위로 검토하는 편이 타당하다.
참고 음성을 입력할 수 있다는 기능도 제작 관점에서는 따져볼 부분이다. 어떤 목소리를 기준으로 삼을 것인지, 해당 음성을 사용할 권한이 있는지, 여러 장면에서 같은 인물로 들리도록 결과를 관리할 수 있는지 확인해야 한다. 특히 실제 인물의 목소리를 참고 자료로 쓰는 작업이라면 기술적 가능성과 별개로 사용 허락과 제작 목적을 먼저 점검할 필요가 있다.
사운드 제작자의 역할은 어디로 이동할까
이 기술을 두고 “이제 효과음을 찾거나 녹음할 필요가 없다”고 말하기는 이르다. 현장 녹음에는 배우의 실제 연기와 공간의 울림이 담긴다. 별도 효과음 작업에는 소리를 장면의 시간에 정확히 맞추고, 반복되는 소리 사이에 변화를 주는 판단이 들어간다. 하나의 오디오를 빠르게 생성하는 기능이 이 모든 작업의 결과를 대신하는지는 아직 검증되지 않았다.
그럼에도 장면의 소리를 먼저 듣고 결정하는 과정에는 변화가 생길 수 있다. 과거에는 원하는 사운드를 설명한 뒤 자료를 찾고 조합해서 첫 시안을 들었다면, 이제는 그 설명 자체를 입력으로 삼아 초기 시안을 생성해볼 수 있다. 제작자는 결과를 들으며 “빗소리가 너무 앞에 있다”, “대사가 끝난 뒤 침묵이 더 길어야 한다”, “발소리가 들리는 시점을 늦추자”처럼 연출 의도를 구체화할 수 있다.
결국 더 중요해지는 것은 어떤 효과음을 넣을지 나열하는 능력만이 아니다. 관객에게 언제 무엇을 들려줄 것인지 판단하는 능력이다. 같은 기차역 장면에서도 열차 소리가 이별을 재촉할 수 있고, 비가 잦아드는 순간이 인물의 말을 더 또렷하게 만들 수 있다. 소리는 장면을 꾸미는 재료이면서 이야기를 전달하는 순서이기도 하다.
Qwen-Audio-3.1-TTS-Next는 그 순서를 글로 설계해 오디오 시안으로 바꿀 수 있다는 가능성을 보여준다. 현재 지원 언어와 생성 길이, 후반 편집 가능성에는 확인해야 할 조건이 남아 있다. 이 모델의 가치는 발표된 기능 목록보다도, 제작자가 실제 장면을 만들고 고치는 과정에서 얼마나 정밀하게 소리를 통제할 수 있는지에 따라 평가받을 것이다.
참고자료: 알리바바 클라우드 발표 · Qwen-Audio-3.1-TTS-Next 모델 사양 · 오디오 생성 사용 안내