지난 8월 1일 오픈AI는 수학과 이론컴퓨터과학에서 오랫동안 풀리지 않았던 문제 10건에 새로운 결과를 냈다고 발표했다. 이번 연구에는 아직 일반에 공개되지 않은 차세대 모델 제품군 '아스트라(Astra)'의 내부 버전이 사용됐다.
이번 연구에서 다룬 문제들은 고차원 기하학과 부호이론, 군론, 양자 복잡도, 격자 암호학, 극단 조합론 등 8개 분야에 걸쳐 있다. 다만 공개된 10건의 성격은 조금씩 다르다. 새로운 해답을 제시한 문제도 있고, 기존 추측을 뒤집는 반례를 찾아낸 경우도 있으며, 이미 알려진 결과의 한계를 더 넓힌 사례도 있다. 따라서 10건 모두를 ‘난제 해결’로 묶기보다는, 해결과 의미 있는 진전이 함께 나온 연구 결과로 보는 편이 정확하다.
AI 증명의 기계 검증
이번 발표를 이해하려면 결과 자체뿐 아니라, 오픈AI가 이를 어떤 방식으로 검증하고 공개했는지도 함께 볼 필요가 있다. AI가 미해결 문제의 답을 제시했다는 주장에는 자연스럽게 한 가지 질문이 따라오기 때문이다. 그 답이 정말 새로운 것인지, 그리고 실제로 맞는지를 어떻게 확인할 수 있느냐는 문제다.
오픈AI는 이전에도 비슷한 논란을 겪었다. 2025년 10월 당시 오픈AI의 과학 연구 조직 'OpenAI for Science'를 이끌던 케빈 와일은 GPT-5가 수학자 폴 에르되시가 남긴 미해결 문제 10개를 풀고 11개에서 진전을 냈다는 취지의 글을 올렸다. 하지만 이후 에르되시 문제 데이터베이스를 관리하는 수학자 토머스 블룸 등이 내용을 확인하면서 상황이 달라졌다. 모델이 찾아낸 결과는 새로운 풀이가 아니라, 이미 다른 연구자들이 발표했지만 데이터베이스에 아직 반영되지 않았던 기존 문헌의 해법이었다. 결국 AI가 새로운 답을 만들어낸 사례라기보다, 데이터베이스 밖에 있던 기존 해법을 찾아낸 사례에 가까웠다. 와일은 이후 자신의 해석이 잘못됐음을 인정하고 해당 게시물을 삭제했다.
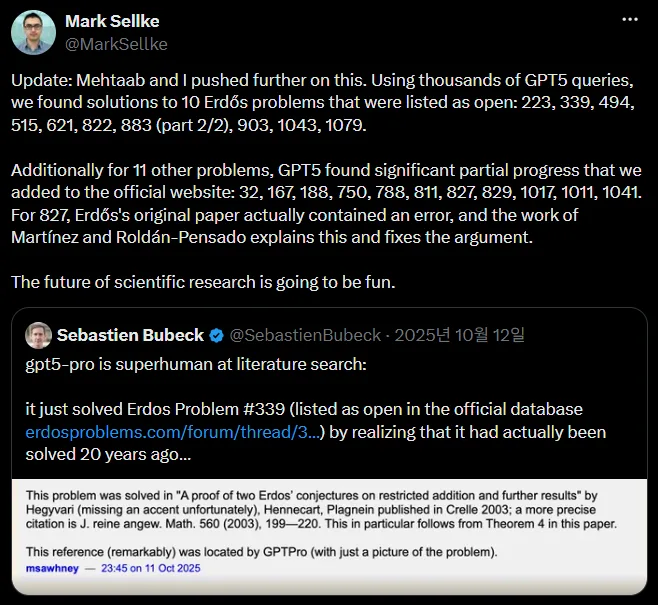
이 사건은 AI가 연구에 들어올 때 '검색'과 '발견'을 구분하는 일이 얼마나 중요한지를 보여줬다. 기존 논문 속에 이미 존재하는 답을 찾아내는 것과, 아무도 알지 못했던 해답을 새로 만들어내는 것은 연구에서 전혀 다른 성과이기 때문이다. 그래서 이번 10개 결과에서는 단순히 AI가 답을 냈다는 주장만으로는 충분하지 않았다. 그 답이 실제로 성립하는지 외부에서도 확인할 수 있는 방법이 필요했다.
여기서 등장한 것이 'Lean 4'다. 오픈AI는 약 250쪽에 이르는 연구 결과와 함께, 10개 결과를 Lean 4라는 형식 증명 시스템으로 옮긴 자료를 깃허브에 공개했다. 구 채우기와 비소픽 군, 콘의 강직성 추측, 양자 병렬 반복 등 각 결과에 대응하는 Lean 파일이 포함돼 있고, 외부 연구자도 이를 직접 실행해 증명이 시스템의 규칙을 통과하는지 확인할 수 있다.
Lean은 또 다른 AI가 답을 읽고 "맞는 것 같다"고 평가하는 방식이 아니다. 사람이 사용하는 수학적 정의와 논리 전개를 컴퓨터가 처리할 수 있는 형태로 옮긴 뒤, 앞의 가정에서 뒤의 결론이 실제로 따라오는지를 하나씩 검사하는 프로그램이다. 수학자가 자연어로 쓴 증명에서는 익숙한 과정을 생략하거나 '당연하다'고 넘어갈 수 있지만, Lean에서는 필요한 논리 단계가 명시되어야 한다. 정해진 규칙으로 다음 단계가 나오지 않으면 증명은 통과하지 않는다.
프로그래밍에 비유하면 조금 이해하기 쉽다. 사람이 코드를 읽고 "대체로 맞아 보인다"고 판단하는 것이 아니라, 실제로 컴파일해 오류가 발생하는지를 확인하는 것에 가깝다. 물론 수학 증명과 프로그램은 같은 것은 아니지만, 긴 논증을 다시 사람의 감각에만 의존해 확인하지 않아도 된다는 점에서는 비슷하다.
Lean에서 검사할 수 있도록 수학적 논리를 엄격한 형식으로 옮겨놓은 것을 ‘형식 증명’이라고 한다. 여기서는 이미 만들어진 풀이가 논리적으로 제대로 이어지는지를 컴퓨터가 확인할 수 있다. 하지만 문제를 처음 마주했을 때 어떤 방법을 시도할지, 기존의 여러 아이디어를 어떻게 연결할지는 별개의 문제다. 오픈AI가 아스트라가 논증을 만들었다고 설명하는 것은 이 앞단의 작업을 뜻한다.
오픈AI의 설명에 따르면 아스트라가 먼저 수학적 논증을 만들고, 연구자들이 이를 논문 형태로 정리한 뒤 다시 모델을 이용해 Lean 증명으로 형식화했다. 자연어로 작성된 증명을 사람이 읽고 판단하는 것과 별개로, 같은 논리를 컴퓨터가 검사할 수 있는 형태로 한 번 더 옮긴 것이다. 덕분에 이번 결과는 단순히 "AI가 답을 냈다"는 주장에 머물지 않는다. 공개된 Lean 증명을 이용하면 다른 연구자들도 형식화된 증명이 Lean의 논리 규칙을 제대로 통과하는지를 직접 확인할 수 있다.
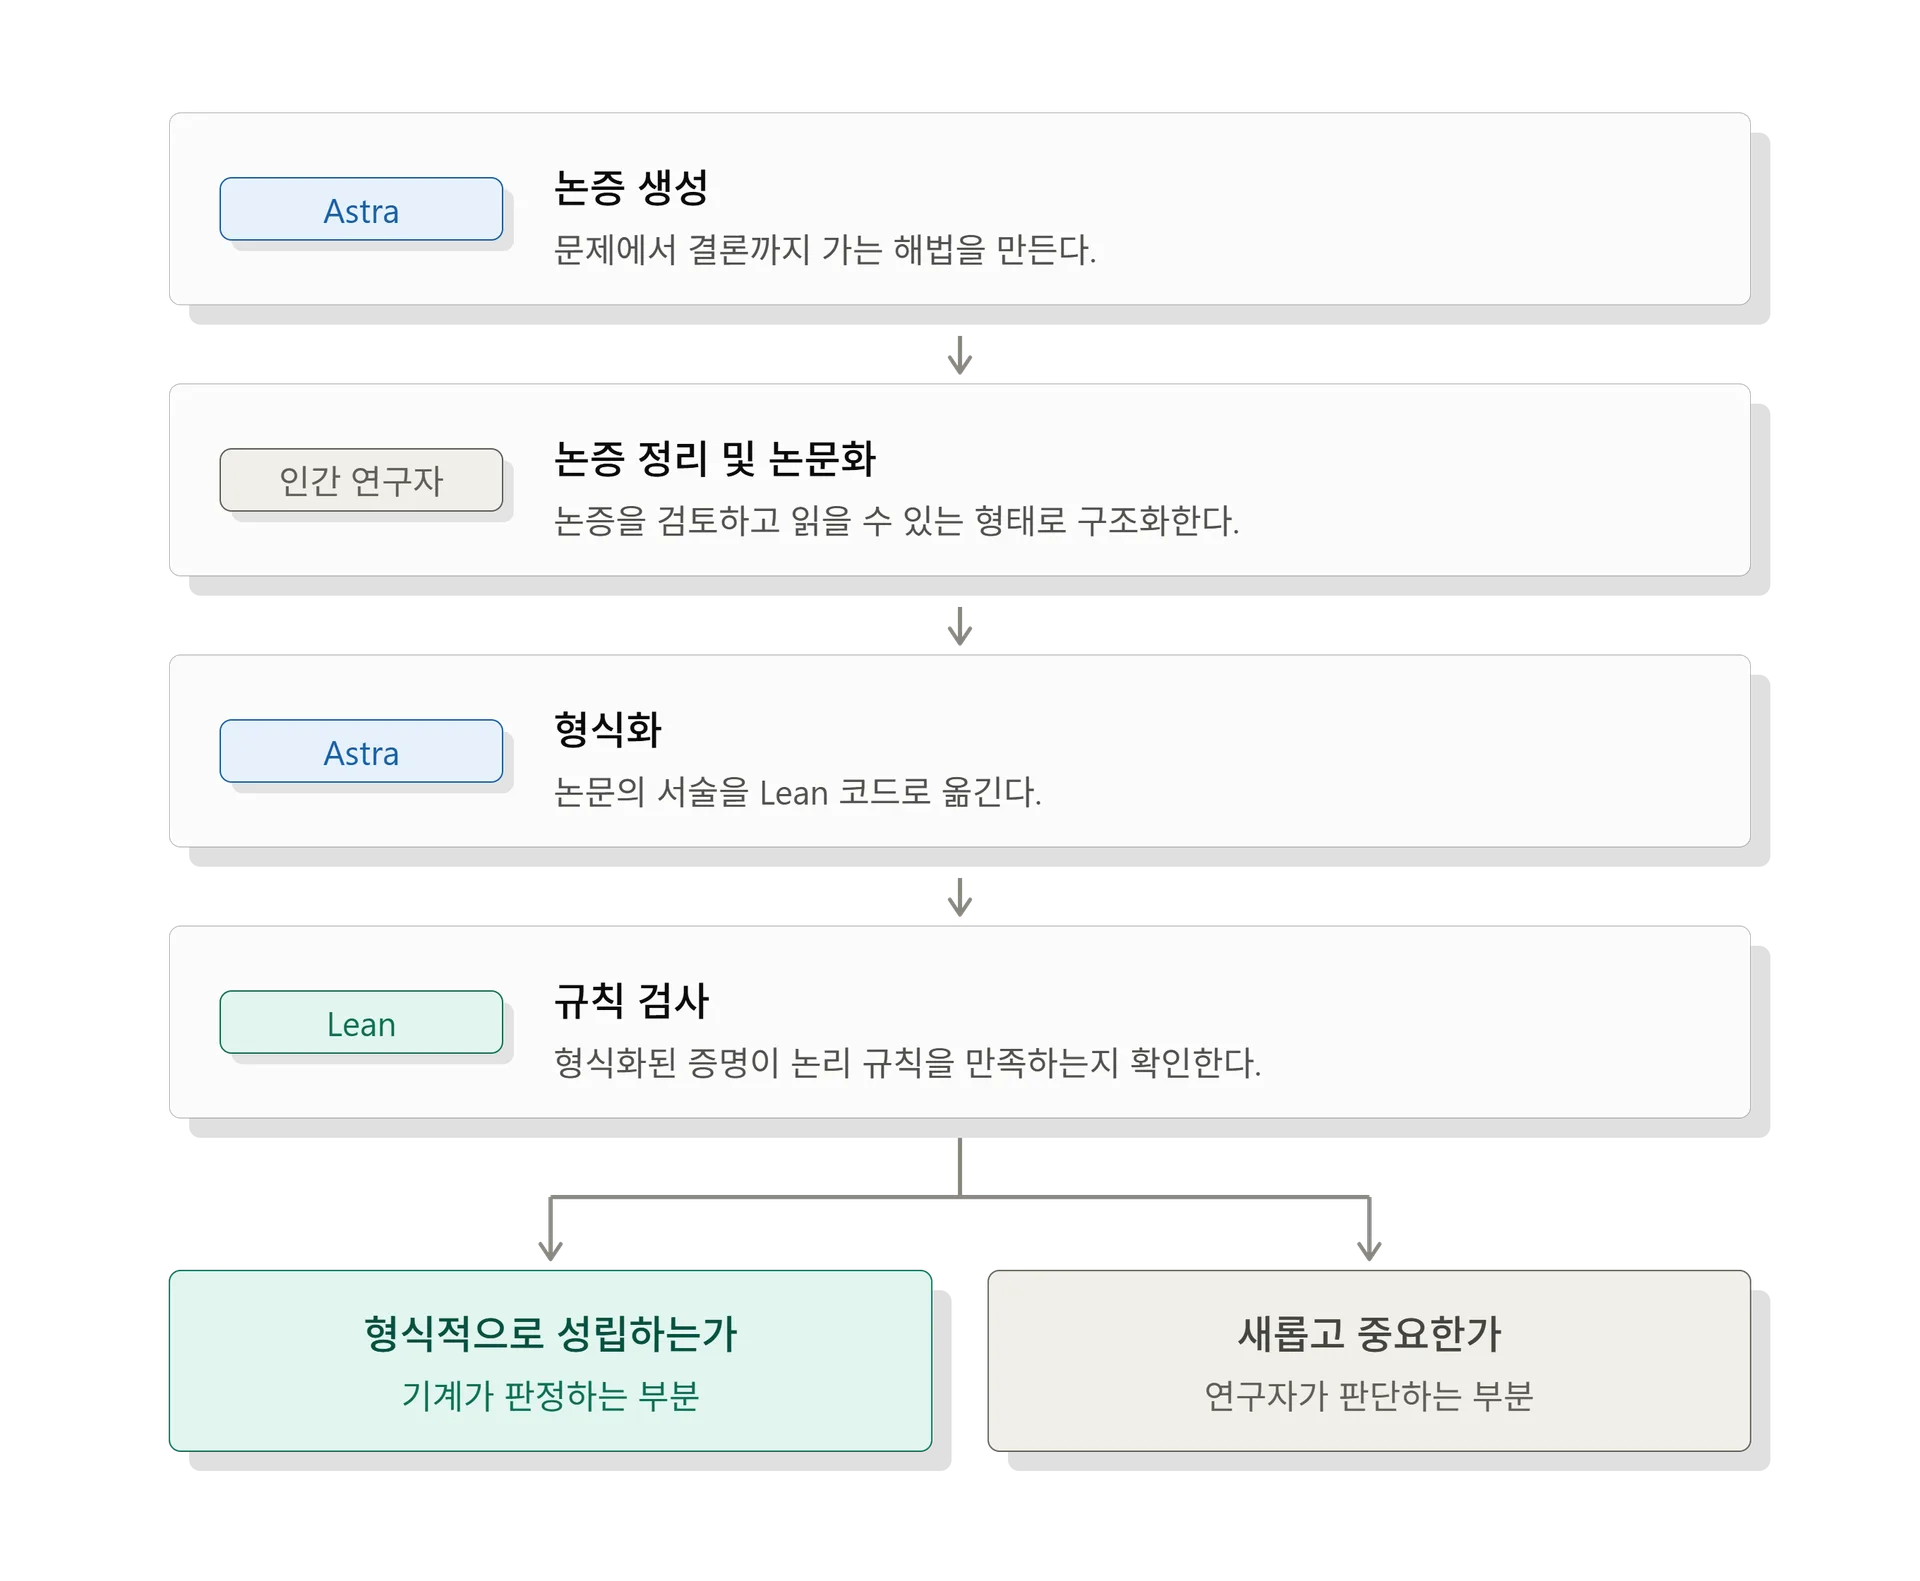
그렇다고 Lean이 모든 판단을 대신하는 것은 아니다. 형식화된 명제와 가정 안에서 논리가 올바르게 이어지는지는 확인할 수 있지만, 그 문제가 원래의 미해결 문제를 정확히 옮겼는지, 비슷한 방법이 이미 다른 연구에 사용됐는지, 결과가 얼마나 새롭고 중요한지는 별도로 판단해야 한다.
결국 이번 발표에서는 두 종류의 검증이 나뉜다. 하나는 증명의 논리가 맞는지를 확인하는 검증이고, 다른 하나는 그 결과가 연구로서 얼마나 새롭고 의미 있는지를 판단하는 검증이다. 첫 번째에는 기계가 상당한 역할을 할 수 있게 됐지만, 두 번째는 여전히 연구자의 몫이다.
새로움과 공로를 둘러싼 논쟁
AI가 실제 연구 문제에 답을 내놓기 시작하면서, 그다음 질문도 자연스럽게 따라왔다. 결과가 논리적으로 성립하는 것과 그것이 새로운 연구라고 인정받는 것은 같은 문제일까.
오픈AI의 발표 이후 나온 비판도 주로 이 지점에 모였다. 흥미로운 점은 논쟁의 중심이 "증명이 틀렸다"는 데 있지 않았다는 것이다. 수학자들이 문제 삼은 것은 일부 결과가 최근의 선행 연구에 얼마나 크게 기대고 있었는지, 그리고 그 기여가 발표 과정에서 충분히 드러났는지였다.
대표적인 사례가 고차원 구 채우기 문제다. 구 채우기는 공간에 같은 크기의 구를 서로 겹치지 않게 얼마나 촘촘하게 배치할 수 있는지를 다루는 문제로, 차원이 높아질수록 훨씬 복잡해진다.
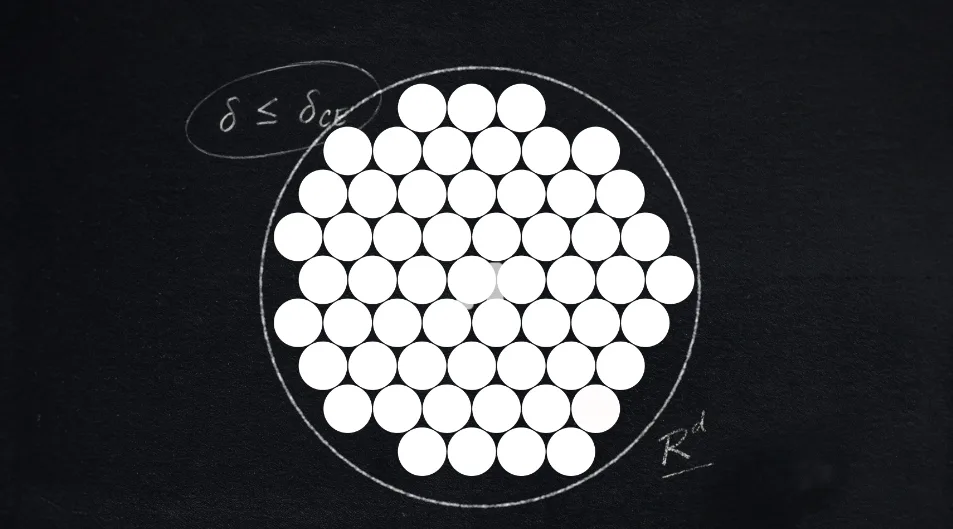
이번 결과에서 아스트라는 구를 얼마나 촘촘하게 배치할 수 있는지에 대한 기존의 상한을 개선했는데, 예시바대 수학자 스티븐 밀러는 'Scientific American'과의 인터뷰에서 해당 증명에 사용된 핵심 논증 가운데 하나가 자신과 공동연구자가 2016년 논문에서 사용한 방법과 사실상 같다고 비판했다. 그는 오픈AI가 해당 선행 연구를 충분히 인정하지 않았다고 주장하며 연구 윤리 문제까지 제기했다. 다만 이는 밀러의 주장으로, 현재 공식적인 연구부정 판정이 내려졌다는 뜻은 아니다.
고차원 구 채우기 논쟁이 선행 연구를 얼마나 제대로 인정했느냐에 가까웠다면, 비소픽 군에서는 한 걸음 더 나아가 기존 연구와 AI의 새로운 기여를 어디에서 나눌 것인가가 쟁점이 됐다.
수학에서 ‘군’은 대칭이나 회전 같은 변환들을 일정한 규칙에 따라 서로 조합할 수 있도록 묶은 구조를 뜻한다. 군론에서는 오랫동안 이런 군이 모두 ‘소픽’이라는 성질을 갖는지, 아니면 그렇지 않은 예외가 실제로 존재하는지가 미해결 문제로 남아 있었다. 아스트라는 소픽이 아닌 군의 구체적인 예를 제시하며, 그런 예외가 실제로 존재한다는 답을 내놓았다.
하지만 케임브리지대의 프란체스코 푸르니에-파시오와 관련 분야 연구자들은 이 결과가 완전히 새로운 출발점에서 나온 것은 아니라고 지적했다. 특히 안드레아스 톰과 가보르 쿤이 2016년과 2019년에 발표한 연구가 마지막 해결 단계로 나아가는 데 중요한 기반이 됐다는 것이다.
이 지적이 나온 뒤 오픈AI는 공식 발표문의 표현도 수정했다. 처음에는 대상 문제들이 적어도 10년 동안 핵심 결과에서 진전이 없었다는 취지로 소개했지만, 이후에는 이를 “장기간 열린 문제를 해결하거나 상당한 진전을 이룬 결과”로 바꿨다. 비소픽 군 증명 역시 비교적 최근의 중요한 선행 연구에 크게 기대고 있다는 점을 인정하고, 이를 더 정확하게 반영하도록 설명을 손봤다.
다만 논쟁이 아스트라의 결과 자체를 부정하는 방향으로 흘러간 것은 아니다. 핵심은 기존 연구가 어디까지 길을 닦았고, 아스트라가 그 위에서 무엇을 새로 완성했는가에 있었다. 가보르 쿤의 연구가 문제의 상당 부분을 앞서 밀어붙였더라도, 마지막까지 남아 있던 연결 고리를 찾아 실제 비소픽 군의 구성으로 이어간 과정은 별도의 기여로 볼 수 있다. 결국 쟁점은 결과의 존재 여부가 아니라, 기존 연구 위에 추가된 부분을 어디까지 새로운 발견으로 평가할 것인가에 가까웠다.
이런 공로 문제는 AI가 등장하면서 처음 생긴 것은 아니다. 수학은 원래 앞선 연구의 방법과 결과를 이어받아 다음 단계로 나아가는 학문이다. 한 연구자가 중요한 방법을 만들고, 다른 연구자가 이를 개선한 뒤, 또 다른 연구자가 마지막 단계를 완성하는 경우도 흔하다. 마지막 해결책을 낸 사람이 가장 눈에 띄기 쉽지만, 그 결과가 가능했던 이유는 그 전에 쌓인 연구가 있었기 때문이다.
AI가 이 과정에 들어오면서 기존의 공로 문제는 더 선명해지고 있다. 푸르니에-파시오는 수학 연구를 여러 세대가 함께 쌓아 올리는 피라미드에 비유했다. 마지막 돌을 올린 사람이 가장 주목받기 쉽지만, 그 아래에는 이미 많은 연구가 쌓여 있다는 뜻이다. 마지막 돌을 올린 주체가 AI가 되면, 그 결과만 부각되고 앞선 인간 연구자의 기여가 상대적으로 보이지 않을 수 있다는 우려도 나온다.
이 지점에서 앞서 살펴본 Lean의 역할과 한계도 다시 분명해진다. Lean은 형식화된 증명에서 논리가 제대로 이어지는지를 검사할 수 있다. 하지만 같은 아이디어가 몇 년 전 다른 논문에 등장했는지, 기존 방법을 얼마나 바꿔야 새로운 연구라고 볼 수 있는지, 어떤 연구자의 기여가 결정적이었는지는 판정하지 않는다.
결국 논리적으로 맞는 결과와 학문적으로 새로운 결과는 같은 것이 아니다.
이번 발표는 AI가 수학 연구에 참여할 수 있다는 가능성을 보여줬지만, 동시에 검증해야 할 대상이 하나 더 늘어났다는 점도 드러냈다. 증명이 맞는지뿐 아니라, 어디에서 출발했는지와 어떤 연구를 이어받았는지까지 함께 살펴봐야 하기 때문이다.
AI가 연구 문제의 답을 더 빠르게 만들어낼수록, 이런 판단은 오히려 더 중요해질 수 있다. 그리고 그 변화는 결국 연구자가 앞으로 어떤 역할을 맡게 될 것인지라는 다음 질문으로 이어진다.
AI 시대 연구 과정의 변화
이번 발표가 보여준 변화는 AI가 연구자를 곧바로 대신한다는 데 있지 않다. 더 현실적인 변화는 연구 과정 안에서 사람과 기계가 맡는 일이 조금씩 나뉘기 시작했다는 점이다.
AI는 이제 자료를 찾고 정리하는 수준을 넘어, 실제 미해결 문제에 해답 후보를 제시하는 단계까지 들어오고 있다. Lean과 같은 도구는 만들어진 증명의 일부 검증을 기계에 맡길 수 있게 했다. 반면 어떤 문제가 중요한지, 결과가 정말 새로운지, 기존 연구와 어떤 관계에 있는지는 여전히 사람이 판단해야 한다.
앞으로 AI가 더 많은 해답 후보를 빠르게 만들어낼수록 연구자의 역할도 달라질 수 있다. 모든 과정을 직접 수행하는 것보다, 어떤 질문을 먼저 다룰지 고르고, 수많은 결과 가운데 가치 있는 것을 가려내며, 하나의 답을 다음 연구로 연결하는 능력이 더 중요해질 가능성이 있다.
수학 연구는 문제 하나를 푸는 것으로 끝나지 않는다. 좋은 결과는 새로운 방법을 만들고, 그 방법이 다시 다른 질문을 낳는다. 지금의 AI가 그 단계까지 스스로 해내고 있는지는 아직 분명하지 않다. 이번 성과 역시 실제 미해결 문제에 답을 제시했다는 점에서는 분명 의미가 있지만, 그것이 새로운 연구 방향까지 만들어낼 수 있는지는 더 지켜봐야 한다.
그래서 이번 발표 뒤에 남는 질문은 “AI가 연구자를 대체할까”와는 조금 다르다. AI가 답을 만드는 일이 점점 쉬워질 때, 사람은 무엇을 더 잘해야 하는가에 가깝다.
좋은 문제를 고르고, 결과의 새로움과 중요성을 판단하며, 그 답이 어디에서 출발했는지를 정확하게 밝히는 일. AI가 답을 만드는 시대에, 인간 연구자의 역할은 결국 ‘무엇을 믿고, 무엇을 가치 있다고 볼 것인가’를 판단하는 데 남는 것이 아닐까.