AI가 쓴 글은 점점 사람처럼 보인다.
문장은 자연스러워지고, 과장된 표현은 줄어들고, 한때 AI 문체의 대표적 흔적으로 지목됐던 em dash 사용도 급감하고 있다. 하지만 그렇다고 AI 글쓰기의 흔적이 사라진 것은 아니다. 흔적은 줄어드는 것이 아니라 바뀐다.
마케팅 회사 Graphite가 2026년 10월 1일 공개한 「AI Tells: Opus 5.5 Update」는 이 변화를 정량적으로 보여준다. 이 보고서는 9월 16일 공개한 기존 AI tells 연구에 9월 22일 출시된 Claude Opus 5.5를 추가해 분석한 업데이트다. 연구진은 9,974개의 정렬된 주제에 대해 인간 글과 여러 AI 모델의 글을 비교했다.
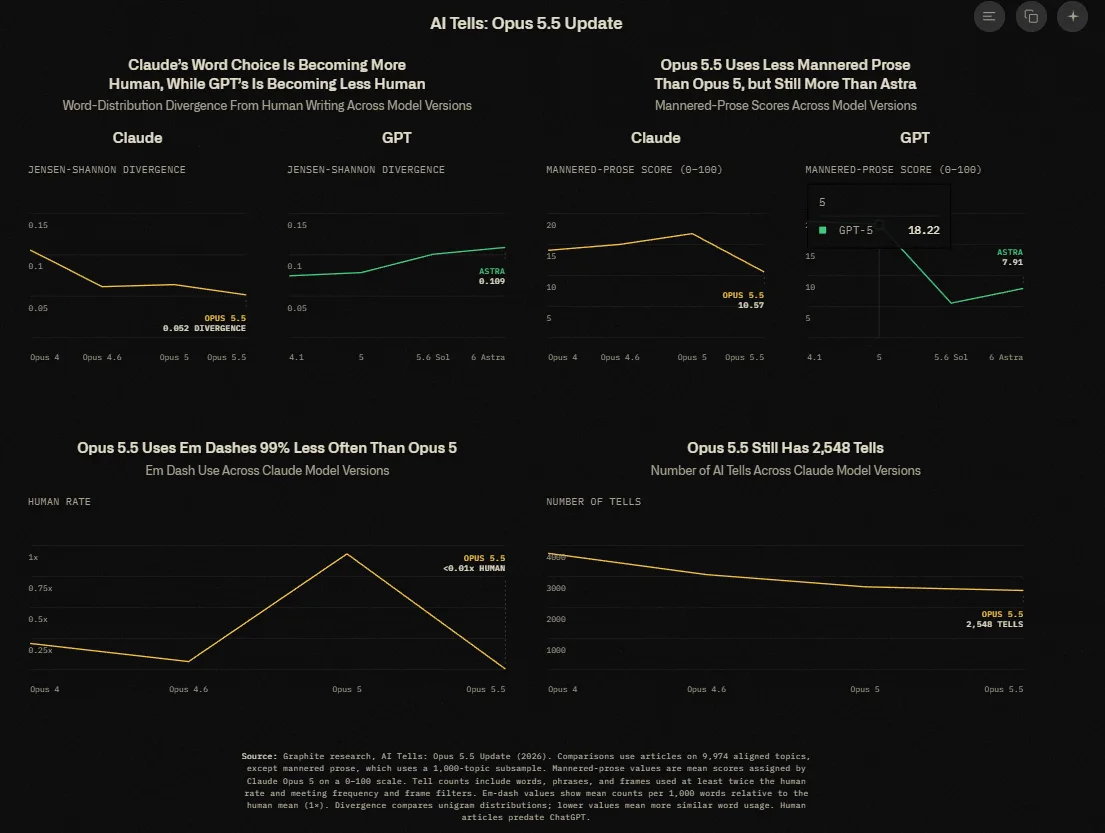
보고서의 핵심 결론은 흥미롭다.
Claude의 단어 선택은 점점 인간 글에 가까워지고 있다. 반면 GPT 계열은 최신 버전으로 갈수록 인간 글과의 단어 분포 차이가 커지는 방향으로 나타났다. Claude Opus 5.5의 인간 글 대비 단어 분포 divergence는 Opus 5보다 19% 낮았다. 반면 GPT-6 Astra는 GPT-5.6 Sol보다 8% 높았다.
이 결과는 AI 글쓰기 논의에서 중요한 전환을 보여준다.
지금까지 많은 사람은 AI 글을 특정 표현으로 알아보려 했다. 예컨대 “delve”, “not only…but also”, “in today’s world”, 과도한 em dash, 결론부의 공식적 마무리 같은 것들이다. 그러나 모델이 업데이트되면 이런 흔한 표지는 빠르게 사라질 수 있다.
Graphite 보고서도 이를 보여준다.
Opus 5.5는 em dash를 Opus 5보다 99% 적게 사용했다. Opus 5는 인간 글의 0.932배 수준으로 em dash를 사용했지만, Opus 5.5는 인간 글 대비 0.005배 수준까지 떨어졌다. 사실상 거의 쓰지 않는 수준이다.
하지만 이것만으로 Opus 5.5가 인간 글과 같아졌다고 말할 수는 없다.
Graphite는 Opus 5.5에서 여전히 2,548개의 AI tell을 발견했다. 이는 Opus 5의 2,666개보다 4% 줄어든 수치에 불과하다. Opus 4의 3,746개, Opus 4.6의 3,059개, Opus 5의 2,666개에서 꾸준히 줄고는 있지만, 여전히 수천 개의 단어·구문·프레임이 인간 글보다 불균형하게 자주 나타난다는 뜻이다.
즉 AI 글쓰기의 흔적은 사라진 것이 아니다.
em dash라는 눈에 띄는 흔적은 사라졌지만, 다른 흔적이 남았다. Opus 5.5는 인간 글보다 “dependable”, “clearer”, “matters”, “quietly”, “practical”, “steady”, “reflects”, “thoughtful”, “genuine” 같은 단어를 과도하게 사용했다. 예를 들어 “dependable”은 인간 글보다 23배, “matters”는 13배, “practical”은 11배 많이 나타났다.
이 단어들의 공통점은 문체적 안전성이다.
Opus 5.5는 글을 안정적이고 실용적이며 의미 있어 보이게 만드는 단어를 자주 사용한다. “중요하다”, “실용적이다”, “더 명확하다”, “신뢰할 수 있다”, “차분하다”는 식의 평가적 언어가 늘어난다. 보고서도 Opus 5.5의 대표적 tell을 평가 형용사, 전환 표현, 대비 구조, 중요성 표시로 분류한다.
특히 “this matters”는 인간 글보다 116배, “why matters”는 92배, “is more than a it”은 98배 많이 나타났다.
이것은 AI 글쓰기의 한 특징을 보여준다.
AI는 독자에게 무엇이 중요한지 자주 알려준다.
AI는 대비 구조를 자주 만든다.
AI는 직접 설명보다 “이것은 단순히 A가 아니라 B다”라는 프레임을 즐겨 쓴다.
AI는 글을 매끄럽게 연결하기 위해 전환구와 의미 부여 문장을 반복한다.
이런 문장은 읽기 쉽다. 하지만 반복되면 특정한 냄새를 만든다.
Graphite가 말하는 “mannered prose”도 이 지점과 관련된다. 보고서는 mannered prose를 직접적 진술 대신 은유와 수사를 사용하는 문체로 보고, Claude Opus 5를 평가자로 사용해 0~100점으로 측정했다. Opus 5.5의 점수는 10.57로 Opus 5의 16.75보다 37% 낮았다. 그러나 여전히 인간 평균 6.65보다 약 1.6배 높았고, GPT-6 Astra의 7.91보다도 높았다.
여기서 중요한 점은 모델마다 다른 방식으로 AI답다는 것이다.
Opus 5.5는 Opus 5보다 덜 과장되고 덜 수사적이다. 하지만 GPT-6 Astra와 비교하면 여전히 더 많은 수퍼러티브와 구어적 축약형을 사용한다. 보고서는 Opus 5.5가 Astra보다 “the most powerful”을 24배, “the most popular”를 45배, “perhaps the most”를 29배 더 자주 사용한다고 밝혔다.
반면 Astra는 다른 흔적을 갖고 있다.
Astra는 Opus 5.5보다 “therefore”, “distinguish”, “approximately”, “establish”, “merely”, “distinction”, “necessarily”, “solely” 같은 단어를 더 많이 썼다. 이는 보다 논증적이고 법률적·학술적이며 조건을 붙이는 문체에 가깝다.
즉 AI 글쓰기의 문제는 “AI는 이런 단어를 쓴다”가 아니다.
정확히는 “각 모델은 각자의 과대표현을 갖는다”다.
Claude Opus 5.5는 더 인간적이고 부드러운 방향으로 이동했다. 하지만 그 과정에서 “도움”, “실용성”, “중요성”, “명확성”을 강조하는 언어를 더 많이 남겼다. 실제로 Opus 5.5는 Opus 5보다 도움과 편의성을 나타내는 언어를 더 많이 사용했다. “can help you”는 Opus 5보다 8배, “is especially helpful”은 12배, “makes it easier”는 6배 많이 나타났다.
반대로 Opus 5는 더 강한 강조 표현을 많이 사용했다.
“is genuinely”는 Opus 5.5보다 26배, “matters enormously”는 15배, “an enormous amount”는 8배 많이 나타났다.
이 변화는 AI 모델 개발의 방향을 암시한다.
모델 제공사들은 AI가 너무 AI처럼 보이는 것을 줄이려 한다. 사용자는 더 자연스럽고 덜 과장된 문장을 원한다. 그래서 최신 모델은 특정한 문체적 표지를 줄인다. 그러나 모델은 완전히 인간처럼 쓰기보다 새로운 균형점을 찾는다. Opus 5.5는 과한 문학적 수사를 줄였지만, 더 “도움이 되는” 조언형 문체를 강화한 것으로 보인다.
이는 AI 서비스의 제품 철학과도 연결된다.
Claude는 사용자를 도와주는 조언자, 분석가, 글쓰기 파트너의 정체성을 가진다. 그러다 보니 “help”, “helpful”, “helps”, “makes it easier” 같은 언어가 늘어난다. 모델의 브랜드 성격과 튜닝 방향이 문체에 남는 셈이다.
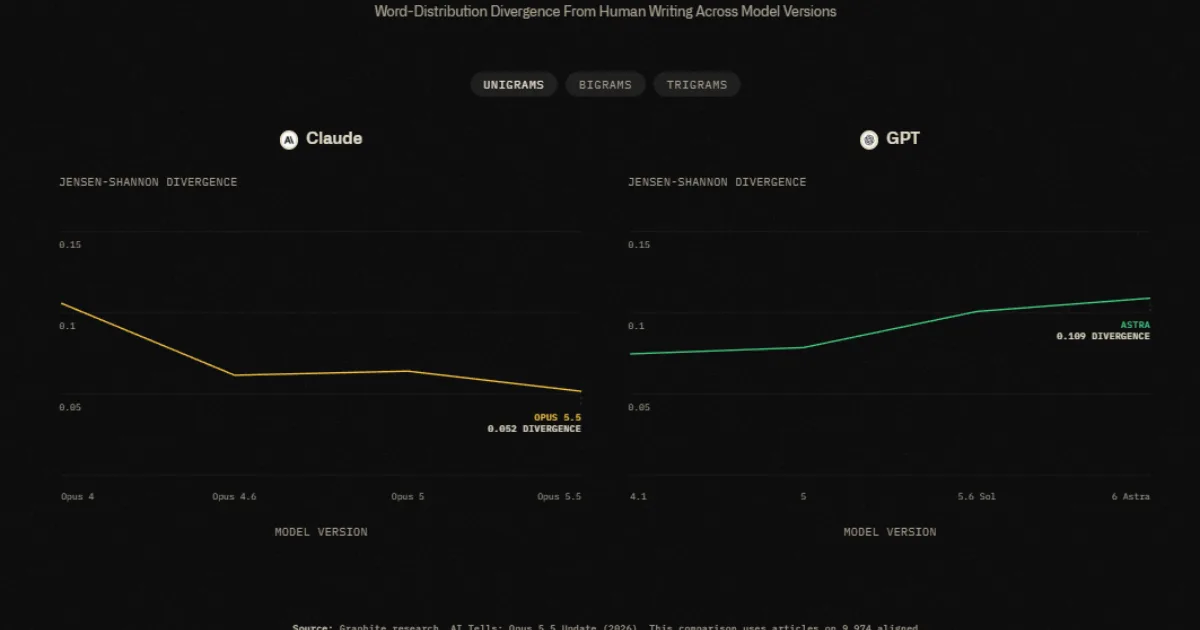
Graphite의 divergence 분석은 더 넓은 그림을 보여준다.
Jensen-Shannon divergence는 모델과 인간 글의 단어·구문 확률분포가 얼마나 다른지를 측정한다. 값이 클수록 인간 글과 멀고, 낮을수록 가깝다. Opus 5.5의 unigram divergence는 0.052로 Opus 5의 0.064보다 낮았다. Opus 4의 0.106과 비교하면 크게 낮아진 수치다. 반면 GPT는 4.1의 0.075, 5의 0.079, 5.6 Sol의 0.101, 6 Astra의 0.109로 상승했다.
이 결과만 보면 Claude는 점점 인간 글에 가까워지고, GPT는 멀어지는 것처럼 보인다.
하지만 이를 단순한 우열로 읽기는 어렵다. Graphite도 여러 측정값이 서로 다른 글쓰기 측면을 포착한다고 설명한다. mannered prose와 well-known tells는 특정 습관을 보고, divergence는 전체 단어 분포를 보며, tell count는 과도하게 자주 쓰이는 단어·구문·프레임의 수를 본다. 어떤 모델은 잘 알려진 tell을 줄이면서도 전체 단어 분포는 인간과 멀어질 수 있고, 반대로 전체적으로 인간에 가까워지면서도 수천 개의 tell을 유지할 수 있다.
이것이 핵심이다.
AI 글 탐지는 더 이상 단일 신호로 되지 않는다.
em dash를 많이 쓰면 AI일 가능성이 높다고 말하던 시대는 끝나고 있다. 최신 모델은 그런 표지를 알고 피하는 것처럼 보인다. 하지만 단어 분포, 반복되는 프레임, 평가 형용사, 전환 구조, 중요성 강조 방식, 문장 길이 변동성 같은 더 미세한 신호는 남는다.
AI 글은 점점 사람 같아진다.
그러나 사람처럼 보이기 위해 특정한 방식으로 조정되면서 또 다른 흔적을 만든다.
이것은 탐지자와 생성자의 반복 게임이다.
탐지자는 AI의 특징을 찾는다.
모델 개발자는 그 특징을 줄인다.
그러면 새로운 특징이 생긴다.
탐지자는 다시 그 특징을 찾는다.
Graphite의 결론도 이 방향이다. Opus 5.5는 Opus 5보다 인간 글에 가까운 단어 선택을 보이고, mannered prose와 em dash 사용을 줄였지만, 여전히 2,548개의 tell을 보인다. 일부 tell은 덜 흔해지고, 다른 tell은 더 흔해졌다.
이 연구가 중요한 이유는 AI 글쓰기의 진화가 콘텐츠 생태계에 직접 영향을 주기 때문이다.
첫째, AI 탐지는 더 어려워진다.
기존 탐지기는 특정 단어, 구두점, 문장 구조, 과도한 균형감 같은 표지에 의존했다. 그러나 모델이 업데이트되면 이런 표지는 빠르게 낡는다. Opus 5.5의 em dash 급감은 대표적 사례다. 사람이 “AI 글 같다”고 느끼는 감각은 곧 구식이 될 수 있다.
둘째, 인간 글의 기준도 흔들린다.
AI가 인간 글에 가까워질수록 인간 작가도 영향을 받는다. 블로그, 기사, 보고서, 마케팅 문구, 이메일, 제안서에서 AI 문체가 확산되면 인간도 그 문체를 따라 쓰게 된다. 그렇게 되면 무엇이 인간다운 글인지, 무엇이 AI다운 글인지의 경계도 이동한다.
셋째, 플랫폼의 신뢰 문제로 이어진다.
검색, 뉴스, 리뷰, 상품 설명, 교육 자료, 연구 요약, 기업 블로그가 AI 글로 채워질수록 독자는 출처와 품질을 더 따져야 한다. AI 글이 사람처럼 보인다고 해서 검증된 글은 아니다. 반대로 AI 흔적이 있다고 해서 무조건 품질이 낮은 것도 아니다. 문제는 투명성과 책임이다.
넷째, 글쓰기 교육의 방향도 달라진다.
앞으로 “AI처럼 쓰지 말라”는 조언은 충분하지 않다. 어떤 AI처럼 쓰지 말아야 하는지를 알아야 한다. 과도한 대비 구조, “이것이 중요한 이유” 식의 반복, 도움말형 문체, 추상적 평가 형용사, 균형 잡힌 듯하지만 구체성이 부족한 문장을 줄이는 훈련이 필요하다.
특히 저널리즘과 분석 글쓰기에서는 이 문제가 중요하다.
AI는 구조를 잘 만든다. 하지만 구조가 너무 매끈하면 현장감이 사라진다. AI는 의미를 잘 부여한다. 하지만 의미 부여가 많아지면 사실보다 해석이 앞선다. AI는 균형 잡힌 문장을 좋아한다. 하지만 균형감이 지나치면 날카로운 판단이 무뎌진다.
좋은 글은 AI tell을 피하는 글이 아니다.
좋은 글은 구체적 사실, 관찰, 판단, 리듬, 책임 있는 문장으로 자기만의 밀도를 갖는 글이다. AI가 자주 쓰는 단어를 피하는 것만으로 인간다운 글이 되지는 않는다. 오히려 중요한 것은 글쓴이의 경험과 문제의식, 문장 선택의 이유가 드러나는가다.
Graphite 연구는 AI 글의 흔적을 수치로 보여주지만, 동시에 인간 글의 과제도 드러낸다.
AI는 점점 덜 튄다.
AI는 과거의 흔적을 지운다.
AI는 새로운 흔적을 만든다.
따라서 인간 글은 단순히 AI와 달라 보이는 것을 넘어, 왜 인간이 썼는지 느껴지게 해야 한다.
이번 보고서의 또 다른 의미는 “AI 탐지”라는 시장의 불안정성이다.
모델이 바뀌면 tell도 바뀐다. Opus 5.5는 Opus 5와 다른 tell을 갖고, Astra는 Opus 5.5와 다른 tell을 갖는다. 따라서 특정 탐지기가 특정 시점의 모델 특성에 맞춰져 있다면, 다음 모델 업데이트 이후 정확도는 크게 달라질 수 있다. Graphite가 말하듯 AI tells는 사라지지 않지만, 모델과 버전에 따라 바뀐다.
이는 교육기관과 언론사, 기업에도 시사점을 준다.
AI 사용 여부를 판단할 때 단일 탐지 점수에 의존해서는 안 된다. 문체 신호는 참고자료일 뿐이다. 작성 과정, 출처, 원자료, 수정 이력, 사실 검증, 책임 주체를 함께 봐야 한다. 특히 AI 글이 점점 사람처럼 변할수록 “탐지”보다 “투명한 사용 규칙”이 중요해진다.
결국 AI 글쓰기의 미래는 두 방향으로 갈 가능성이 크다.
하나는 모델이 더 인간처럼 쓰는 방향이다. 단어 분포는 인간에 가까워지고, 과장된 표현은 줄며, 눈에 띄는 표지는 사라진다.
다른 하나는 모델별 정체성이 더 분명해지는 방향이다. Claude는 도움과 실용성을 강조하고, GPT는 논증적·분석적 구조를 강화하며, Gemini는 또 다른 언어 습관을 남길 수 있다. 사용자는 “AI 글”이 아니라 “어떤 모델의 글”을 구분하게 될지도 모른다.
Graphite의 Opus 5.5 업데이트는 바로 이 전환을 보여준다.
AI 글은 더 이상 하나의 문체가 아니다.
모델마다 다른 문체가 있고, 버전마다 다른 흔적이 있다.
사람 같아지는 방향도 같지 않다.
그래서 “AI가 쓴 글을 어떻게 알아볼까”라는 질문은 점점 어려워진다.
더 정확한 질문은 이것이다.
이 글은 어떤 언어 습관을 반복하고 있는가.
이 문체는 어떤 모델의 최적화 흔적을 담고 있는가.
이 글은 실제 관찰과 판단에서 나온 것인가, 아니면 매끄러운 패턴의 조합인가.
AI 글쓰기의 흔적은 지워지는 것이 아니다.
형태를 바꿀 뿐이다.