Sparks of In Silico Cognitive Science: Theories from Simulated Data Can Generalize to Humans (2026)
Akshay K. Jagadish·Younes Strittmatter·Nori Jacoby·Eric Schulz·Nathaniel Daw·Thomas L. Griffiths·Suyog H. Chandramouli
arXiv:2609.08003
시뮬레이션 데이터를 이용한 자동화된 인지과학의 가능성
심리학에서 인간 참가자를 AI로 대체하려는 시도에는 늘 같은 문제가 따라붙는다. AI가 인간처럼 답한다고 해도, 그 데이터를 통해 발견한 법칙이 인간의 인지 구조를 설명하는지, 아니면 AI 시뮬레이터의 행동을 설명하는지 알기 어렵다는 문제다. Jagadish와 동료들의 〈Sparks of In Silico Cognitive Science: Theories from Simulated Data Can Generalize to Humans〉는 이 질문을 직접 실험한다. 연구진은 인간 행동을 모사하도록 학습된 파운데이션 모델 Centaur에게 실험 참가자 역할을 맡기고, 그 데이터만으로 새로운 의사결정 이론을 발견했다. 이후 해당 이론을 실제 인간 데이터에 적용했다. 결과는 뜻밖이다. 시뮬레이션에서 발견된 이론이 기존의 대표적 인간 의사결정 이론보다 인간 행동을 더 잘 예측했다.
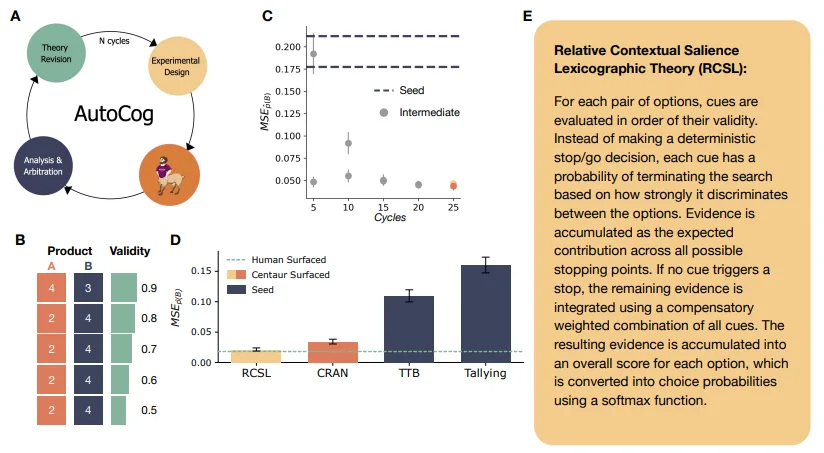
AI가 실험하고, 판정하고, 이론까지 다시 쓴다
연구의 중심에는 AUTOCOG(Automated Cognitive Scientist)라는 자동화된 과학자 시스템이 있다. 두 개의 경쟁 이론을 출발점으로 삼아 ① 어느 이론이 맞는지 구별할 실험을 LLM이 설계하고, ② Centaur가 참가자가 되어 약 96개의 선택 과제를 수행하며, ③ 두 이론의 예측과 Centaur의 응답을 비교해 승자를 가린 뒤, ④ 성능이 낮은 이론을 LLM이 수정하거나 새로운 메커니즘으로 교체한다. 연구에서는 이 과정을 25회 반복했다. 중요한 점은 후보 이론 목록에서 하나를 고르는 방식이 아니라, 프로그램 합성을 통해 새로운 계산 메커니즘을 계속 만들어낸다는 것이다. 따라서 시스템이 탐색하는 대상은 매개변수의 값보다 ‘사람이 어떤 규칙으로 판단하는가’라는 이론의 구조에 가깝다.
실험 과제는 두 상품 가운데 하나를 고르는 다속성 의사결정 문제다. 각 상품은 최대 다섯 개의 특성을 가지며, 각 특성에는 판단에서 얼마나 신뢰할 수 있는지를 나타내는 validity가 부여된다. 출발점은 고전적인 Take-The-Best(TTB)와 Tallying이었다. TTB는 신뢰도가 높은 단서부터 살펴보다 두 선택지를 구별하는 단서가 나오면 판단을 멈춘다. Tallying은 어느 쪽이 더 많은 특성에서 우세한지만 센다. 각각 ‘하나의 결정적 근거’와 ‘다수결’에 가까운 모델이다.
시뮬레이션이 발견한 것은 ‘상황에 따라 판단방식이 바뀐다’는 구조였다
25회의 경쟁 끝에 살아남은 이론은 RCSL(Relative Contextual Salience Lexicographic)과 CRAN(Contextual Relative Advantage Normalization)이다. 두 이론 모두 기존 이론의 요소를 섞었지만, 출발점에 없던 계산구조를 갖는다. 특히 인간 데이터에서 가장 좋은 성능을 보인 RCSL이 흥미롭다.
RCSL은 TTB처럼 중요한 특성부터 확인하지만, 차이가 발견되었다고 바로 판단을 끝내지 않는다. 두 상품 사이의 차이가 얼마나 큰지에 따라 그 특성에서 탐색을 멈출 확률이 달라진다. 차이가 크면 그 특성 하나가 결정에 강하게 작용하고, 차이가 작으면 다음 특성으로 넘어갈 가능성이 커진다. 끝까지 결정적인 특성이 나오지 않으면 여러 특성을 가중 합산한다. 사람의 판단을 ‘한 가지 휴리스틱을 고정적으로 사용한다’고 보는 대신, 단서 하나에 기대는 방식과 여러 정보를 합산하는 방식 사이를 연속적으로 이동하는 과정으로 모델링한 셈이다.
CRAN은 다른 방향에서 맥락을 끌어들인다. 현재 선택지들 가운데 가장 큰 특성 차이를 기준으로 다른 차이들의 상대적 크기를 계산한다. 어떤 특성에서 압도적인 차이가 발생하면 작은 차이들의 영향은 줄고, 그런 차이가 없다면 여러 작은 우위가 함께 작동한다. 판단 기준이 고정되어 있는 것이 아니라 현재 눈앞에 놓인 선택지들의 차이 분포가 판단의 스케일 자체를 바꾼다는 모델이다.
AI에게서 찾은 이론이 인간에게도 살아남았다
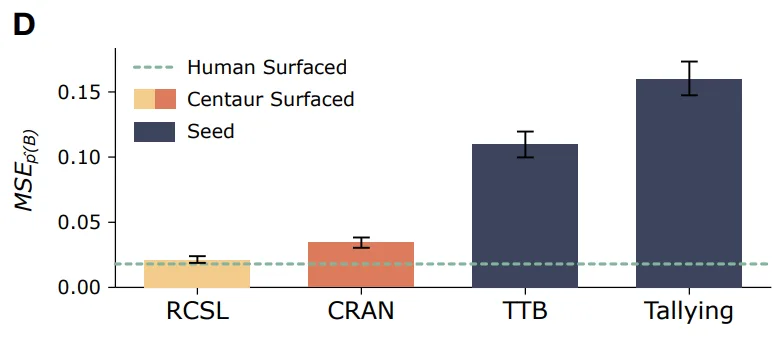
논문의 핵심은 2쪽 Figure 1D에 압축되어 있다. 연구진은 Centaur에서 발견한 이론을 AUTOCOG가 보지 않은 10개의 실제 인간 실험에 적용했다. 평균제곱오차(MSE)는 RCSL이 0.021, CRAN이 0.034였다. 기존 TTB는 0.110, Tallying은 0.161이었다. 인간 데이터를 직접 이용해 AUTOCOG가 발견한 두 이론은 각각 0.018 수준이었다. 즉 사람 없이 발견한 RCSL의 예측력이 인간 데이터를 사용해 발견한 이론과 가까운 수준까지 도달했다.
이 결과에서 연구진이 끌어내는 가장 중요한 통찰은 시뮬레이터가 인간을 완벽하게 복제할 필요가 없다는 것이다. 정확한 인간 행동 값을 추정하려면 시뮬레이터의 오차가 그대로 문제가 된다. 그러나 이론 발견 과정에서 필요한 것은 조금 다르다. 두 경쟁 이론이 서로 다른 예측을 내놓는 지점에서, 시뮬레이터가 인간과 비슷한 방향으로 어느 쪽을 지지하는지만 유지하면 된다. 즉 필요한 것은 전 행동공간의 정밀 복제가 아니라 이론들을 가르는 차이에 대한 충실도다.
그래서 논문이 제안하는 연구 구조도 흥미롭다. 후보 이론들이 서로 크게 다른 초기 탐색 단계에서는 시뮬레이션으로 많은 실험을 돌리고, 이론들의 예측이 서로 가까워지거나 실험이 시뮬레이터의 학습 영역에서 멀어지는 순간 인간 참가자로 전환한다. 시뮬레이터는 넓은 이론 공간을 먼저 헤집고, 인간 데이터는 마지막 관문에서 살아남을 이론을 결정한다. 연구진이 말하는 in silico cognitive science의 핵심은 사람을 없애는 데 있지 않고, 인간에게 묻기 전에 어떤 질문을 물어야 할지 기계가 먼저 탐색하도록 만드는 데 있다.