Loop-Back Authority in LLM Agent Teams: A Paired Experiment on Flat and Hierarchical Coordination(2026)
Burak Agachan·Max van Duijn·Amirhossein Zohrehvand
arXiv:2609.14767
LLM 멀티에이전트에서 ‘관리자의 수정 권한’은 품질을 높이는가
LLM 에이전트를 여러 개 묶으면 자연스럽게 조직도가 등장한다. 연구자, 분석가, 작성자, 비평가가 일하고 그 위에 관리자가 결과를 검토한다. 실제 멀티에이전트 프레임워크에서도 관리자가 작업을 되돌려 보내는 계층형 구조가 널리 쓰인다. Burak Agachan, Max van Duijn, Amirhossein Zohrehvand의 연구는 여기서 한 가지 질문만 떼어냈다. 관리자가 다른 에이전트에게 “다시 해”라고 명령할 수 있게 하면 결과가 좋아지는가?
조직 전체가 아니라 ‘권한 하나’만 바꾼 실험
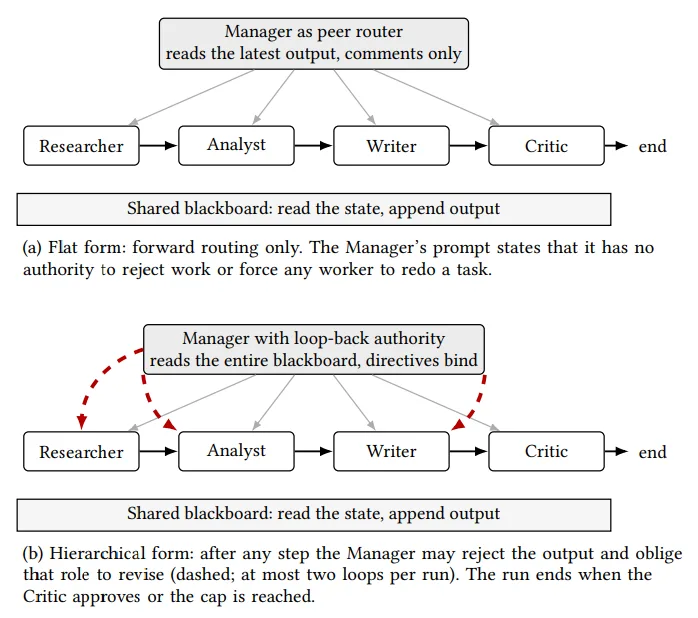
이 연구의 핵심은 비교 방식에 있다. 연구팀은 Researcher, Analyst, Writer, Critic, Manager라는 다섯 역할과 프롬프트, 도구, 모델, 데이터까지 그대로 유지했다. 달라진 것은 Manager와 작업자 사이의 권한 하나다. 평면형에서는 Manager가 의견을 남길 수 있지만 작업을 되돌릴 수 없다. 계층형에서는 Manager가 결과를 거부하고 해당 에이전트에게 수정을 명령할 수 있다. 논문 3쪽의 Figure 1은 두 구조가 이 한 개의 ‘loop-back authority’만 다르다는 점을 보여준다.
43개 제품을 두 구조에서 각각 실행해 86개의 비즈니스 인텔리전스 보고서를 만들었다. 같은 제품에서는 역할별 모델 배치도 동일하게 유지했다. 결과는 Writing Clarity, Utility, 제품 사양 정확도로 평가했다. 즉 “계층제 전체가 좋은가”가 아니라 수정 명령권 자체가 텍스트 생성 과정에 어떤 흔적을 남기는가를 추적한 실험이다.
관리자가 개입했지만 글은 더 좋아지지 않았다
결과표에서 가장 선명한 차이는 Utility와 Writing Clarity다. 평면형은 Utility 4.715, 계층형은 4.621이었고, Writing Clarity도 4.454 대 4.360으로 평면형이 높았다. 반면 제품 사양 정확도에는 차이가 없었다.
세부 항목을 보면 이유가 드러난다. Writing Clarity의 차이는 글의 구조나 논리적 연결이 아니라 Conciseness, 즉 불필요한 문장을 얼마나 덜 쓰는가에서 발생했다. Utility에서는 Strategic Depth가 차이를 만들었다. 관리자가 개입한 보고서는 형식이 무너지지 않았고 사실도 틀리지 않았다. 대신 전략적 해석이 줄고 문장에 단서와 완충 표현이 붙었다.
핵심 결과 | 평면형 | 계층형 | 해석 |
|---|---|---|---|
Writing Clarity | 4.454 | 4.360 | 평면형 우세 |
Utility | 4.715 | 4.621 | 평면형 우세 |
사양 정확도 | 4.520 | 4.543 | 차이 없음 |
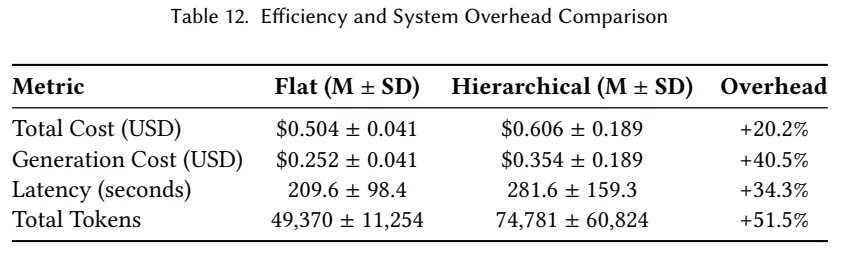
총 토큰 | 49,370 | 74,781 | 계층형 +51.5% |
실행시간 | 약 210초 | 약 282초 | 계층형 +34.3% |
특히 Table 12의 비용 비교가 실무적으로 중요하다. 계층형은 토큰을 51.5% 더 사용했고 생성 비용은 40.5%, 전체 비용은 20.2%, 실행시간은 34.3% 증가했다. 그 추가 계산량이 세 품질 지표 어디에서도 이득으로 돌아오지 않았다.
수정 명령을 받은 LLM은 ‘다시 생각’하지 않았다
가장 흥미로운 부분은 최종 점수보다 초안의 변화다. 계층형 Writer가 Manager의 수정 요구를 받기 전에 작성한 첫 초안은 평면형 보고서와 길이, 어휘 다양성, 완곡 표현 사용량에서 통계적으로 구별되지 않았다. 차이는 수정 요청 이후 생겼다.
수정이 발생한 31개 사례에서 두 번째 초안은 1,000단어당 hedging 표현이 평균 1.95개 늘었고 약 38단어 길어졌다. 그런데 수정본은 이전 초안의 문장 배열을 중앙값 기준 약 88% 유지했고, 내용 어휘도 약 85% 보존했다. 34번의 수정 가운데 큰 폭의 재작성으로 분류될 만한 사례는 없었다. Writer는 분석을 새로 구성하기보다 기존 글에 possible, may, suggests, could 같은 표현과 추가 설명을 붙였다.
여기서 논문의 중요한 해석이 나온다. 수정 루프는 모델의 생각을 붕괴시키기보다 주장의 강도를 낮춘다. 저자들은 이를 강한 의미의 ‘Degeneration-of-Thought’보다 권위적 지시에 맞추는 sycophantic compliance에 가깝다고 본다. 계층형 최종 보고서는 평면형보다 1,000단어당 hedging 표현을 53% 더 사용했지만 어휘 다양성에는 차이가 없었다.
LLM에게 권위는 통제선이 아니라 입력 신호다
이 연구가 멀티에이전트 설계에 던지는 가장 큰 논점은 여기 있다. 전통적인 조직 모델에서 관리자의 권한은 작업 흐름을 제어하는 통로다. 하지만 LLM에서 “관리자가 수정하라고 명령한다”는 사실은 작업을 라우팅하는 신호인 동시에 다음 출력을 바꾸는 프롬프트가 된다. 이 실험에서는 명령을 거부해도 제재가 없었다. 그런데도 Writer는 문장을 고치고 주장의 강도를 낮췄다. 권한 관계가 텍스트 생성 조건으로 들어간 셈이다.
그래서 저자들이 제시하는 설계 원칙도 명확하다. 관리자가 검증할 수 있는 정보가 있을 때 수정 권한을 부여하고, 품질에 대한 의견만 낼 수 있을 때는 강제 수정 루프를 피하라. 제품 사양처럼 정답을 대조할 수 있는 부분에서는 두 구조 모두 거의 완벽한 정확도를 기록했다. 반면 전략적 해석과 글쓰기처럼 정답표가 없는 부분에서는 관리자의 반복 개입이 문장을 보수적으로 만들었다.
멀티에이전트 시스템에서 중요한 질문은 이제 “Manager가 필요한가?”보다 더 세분화된다. 무엇을 검증할 수 있는가, 어떤 조건에서 수정을 요구하는가, 그리고 그 수정 명령이 생성 모델에게 어떤 사회적 신호로 읽히는가. 이 논문은 조직도를 그리는 문제를 프롬프트와 행동 조건의 문제로 끌어온다. LLM 팀에서 상사를 추가하는 순간 조직도에 선 하나가 생기는 데 그치지 않는다. 그 선이 다음 문장을 바꾼다.