Sparse Reward Subsystem in Large Language Models (2026)
Guowei Xu, Mert Yuksekgonul, James Zou
arXiv:2602.00986
대규모언어모델의 내부 상태에는 답의 정오, 확신도, 환각 여부와 관련된 정보가 들어 있다는 연구가 이어져 왔다. 문제는 그 정보가 수천 개의 뉴런 전체에 퍼져 있는지, 특정 구조에 모여 있는지 알기 어려웠다는 점이다. 칭화대 Guowei Xu와 스탠퍼드대 Mert Yuksekgonul, James Zou의 연구는 LLM의 보상 관련 정보가 전체 hidden state에 균등하게 분산되지 않고, 1% 미만의 소수 뉴런에 집중될 수 있다고 주장한다. 이들은 이를 ‘희소 보상 하위시스템(sparse reward subsystem)’이라 부른다.
답을 쓰기도 전에 “이 문제를 풀 수 있는가”를 계산
저자들이 먼저 찾아낸 것은 value neuron이다. 강화학습의 가치함수처럼 현재 상태에서 출발했을 때 마지막에 정답에 도달할 확률을 나타내는 뉴런이다. 특히 흥미로운 지점은 답변을 한 토큰도 생성하지 않은 질문 입력 직후의 hidden state에서도 이 신호가 나타난다는 것이다. 모델은 풀이를 시작하기 전에 이미 문제와 자신의 관계에 대한 일종의 성공 가능성을 형성하고 있는 셈이다.
왜 이런 정보가 소수 뉴런에 담길 수 있을까. 저자들은 정답 여부가 결국 0과 1의 이진 보상이고, 이를 예측하는 데 필요한 핵심 정보는 이론적으로 하나의 스칼라 값으로 압축될 수 있다고 설명한다. 여기에 superposition 가설을 연결한다. 학습 과정에서 반복적으로 사용되며 중요한 특징일수록 특정 뉴런에 전용 표현을 확보할 가능성이 있다는 것이다. 실제 실험에서도 보상 예측 성능은 뉴런을 99% 가까이 제거한 뒤까지 상당 부분 유지됐다.
1%를 지우자 추론 능력이 무너졌다
이 논문의 강한 장면은 probe의 상관관계보다 뉴런을 직접 꺼버린 실험에서 나온다. Qwen-2.5-7B-SimpleRL-Zoo의 원래 MATH500 정확도는 75.2%였다. 특정 층의 상위 1% value neuron을 0으로 만들자 정확도는 층에 따라 37.0%, 13.6%, 29.4%, 심지어 1.2%까지 떨어졌다. 네 층 평균은 20.3%였다. 반면 같은 수의 뉴런을 무작위로 제거했을 때 평균 정확도는 74.6%로 거의 움직이지 않았다. 일반적으로 중요해 보이는 뉴런을 제거하는 Magnitude나 Wanda 방식보다도 하락폭이 컸다.
여기서 논문의 주장은 “보상을 읽어낼 수 있다”에서 “보상 관련 뉴런이 실제 추론 과정에 관여한다”로 이동한다. 더구나 next-token prediction을 이용해 찾아낸 뉴런과 value neuron의 중첩은 0.7%에 그쳤다. 저자들이 잡아낸 뉴런이 단순히 언어 생성 전반에 중요한 뉴런을 다시 발견한 것은 아니라는 근거다. 데이터셋을 GSM8K, MATH500, ARC, 코딩 문제인 MBPP+, 명령 수행 과제인 IFEval로 바꿔도 희소성이 유지됐고, 같은 기반 모델에서 서로 다른 방식으로 미세조정된 모델 사이에서도 핵심 뉴런의 위치가 무작위 기준보다 강하게 겹쳤다.
추론이 갑자기 좋아지거나 망가지는 순간을 기록하는 뉴런
두 번째 발견은 dopamine neuron이다. 여기서 ‘도파민’은 생물학적 동일성을 뜻하지 않는다. 뇌의 도파민 뉴런이 reward prediction error를 나타내는 것과 기능이 닮았다는 이유로 붙인 이름이다. 모델의 예상 정답 확률이 한 추론 단계 이후 갑자기 높아지면 양의 TD error가, 낮아지면 음의 TD error가 발생한다. 저자들은 문단 단위로 모델을 끊어 각 지점에서 여러 차례 후속 답변을 생성하고, 최종 정답률의 변화를 계산해 이 값을 추정했다.
7쪽의 Figure 3이 이 개념을 직관적으로 보여준다. 처음에는 풀지 못할 것으로 예상했던 문제가 핵심 논리 단계를 발견한 순간 특정 뉴런의 활성값이 솟는다. 반대로 처음에는 성공 가능성이 높던 풀이가 중간에 논리적 오류를 범하면 같은 유형의 뉴런에서 깊은 trough가 나타난다. 모델의 문장을 읽지 않고 내부 활성값만 보더라도 “여기에서 풀이가 살아났다”, “여기에서 경로가 무너졌다”는 신호가 잡히는 것이다. 다른 Minerva Math 사례에서도 핵심 결론 직후 peak와 잘못된 단계 직후 trough가 반복됐다.
‘확신’을 묻지 않고 읽어내고, 내부 신호로 다음 생각을 고른다
이 구조는 해석을 넘어 추론 제어에 사용된다. value neuron으로 답변 생성 전 모델의 정답 가능성을 예측했을 때 평균 AUC는 0.67이었다. 전체 hidden state를 사용하는 LCD는 0.60, 모델에게 직접 확신도를 말하게 한 방식은 0.52, 다음 토큰 확률은 0.48이었다. 흥미롭게도 모델이 입으로 말하는 자신감보다 내부의 소수 뉴런이 정답 가능성을 더 잘 드러낸다.
dopamine neuron은 한 단계 더 나아간다. 모델이 추론 문단 후보 네 개를 생성하면 각 후보의 내부 prediction-error 신호를 읽어 가장 높은 점수를 받은 경로를 다음 단계로 선택한다. MATH500에서 greedy와 random 방식의 정확도는 각각 72.2%, 기존 implicit PRM은 75.0%였지만 dopamine neuron을 이용한 방식은 77.8%를 기록했다. 모델 외부에 별도의 평가기를 세우지 않고 모델 내부에서 발생하는 신호가 다음 생각을 고르는 기준으로 작동한 것이다.
표가 보여주는 논문의 구조
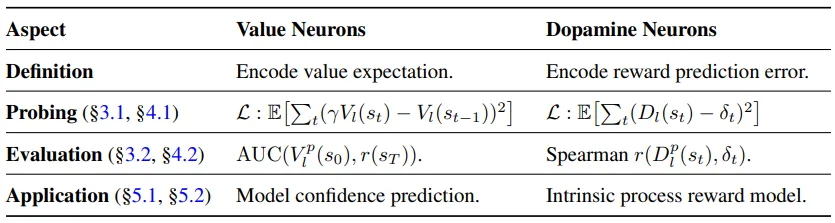
논문의 Table 1은 전체 연구를 두 개의 열로 압축한다. Value neuron은 현재 상태의 예상 가치를 나타내고 모델의 사전 confidence를 예측한다. Dopamine neuron은 이전 상태와 현재 상태 사이의 reward prediction error를 나타내며 process reward model로 사용된다. 이후 표들이 이 구조를 실험으로 채운다. Table 2는 value neuron 1% 제거만으로 정확도가 평균 54.9%p 떨어진다는 인과적 결과를, Table 3은 소수 value neuron의 confidence 예측력이 여러 기존 방식보다 높다는 결과를, Table 4는 dopamine neuron을 이용한 추론 탐색이 정확도를 77.8%까지 끌어올린다는 결과를 보여준다.
이 논문에서 눈에 띄는 변화는 LLM의 추론을 거대한 hidden state 전체의 움직임으로 바라보던 시선을 소수 뉴런의 시간적 변화로 옮긴 데 있다. 모델 내부에는 “현재 경로가 성공할 것인가”를 나타내는 신호와 “방금 생성한 생각이 예상보다 좋았는가 나빴는가”를 나타내는 신호가 분리되어 관찰된다. 그리고 앞선 층의 value neuron을 제거하면 뒤쪽 dopamine neuron의 peak와 trough까지 흐트러진다. 저자들이 이를 하나의 ‘reward subsystem’으로 묶는 이유다.
LLM이 자신의 답을 언어로 평가하기 전에 내부 뉴런은 이미 성공 가능성을 계산하고, 추론이 진행되는 동안 그 기대값의 변화를 기록한다. 이 연구가 제시하는 가장 흥미로운 그림은 바로 여기에 있다. 언어모델의 추론 과정 내부에서 ‘가치’와 ‘예상 밖의 진전’이라는 서로 다른 신호가 발견되고, 그 신호를 다시 읽어 모델의 다음 추론을 선택할 수 있다는 것이다.